Des requêtes comme interface :
modéliser et analyser un jeu de données ouvertes
sur l’histoire du roman français des Lumières (1750–1800)


Christof Schöch
Université de Trèves, Allemagne

Interfaces des Lumières.
(Dé)constructions numériques d’un héritage

09 Oct 2025


Introduction


Plan

  • 1 – Introduction
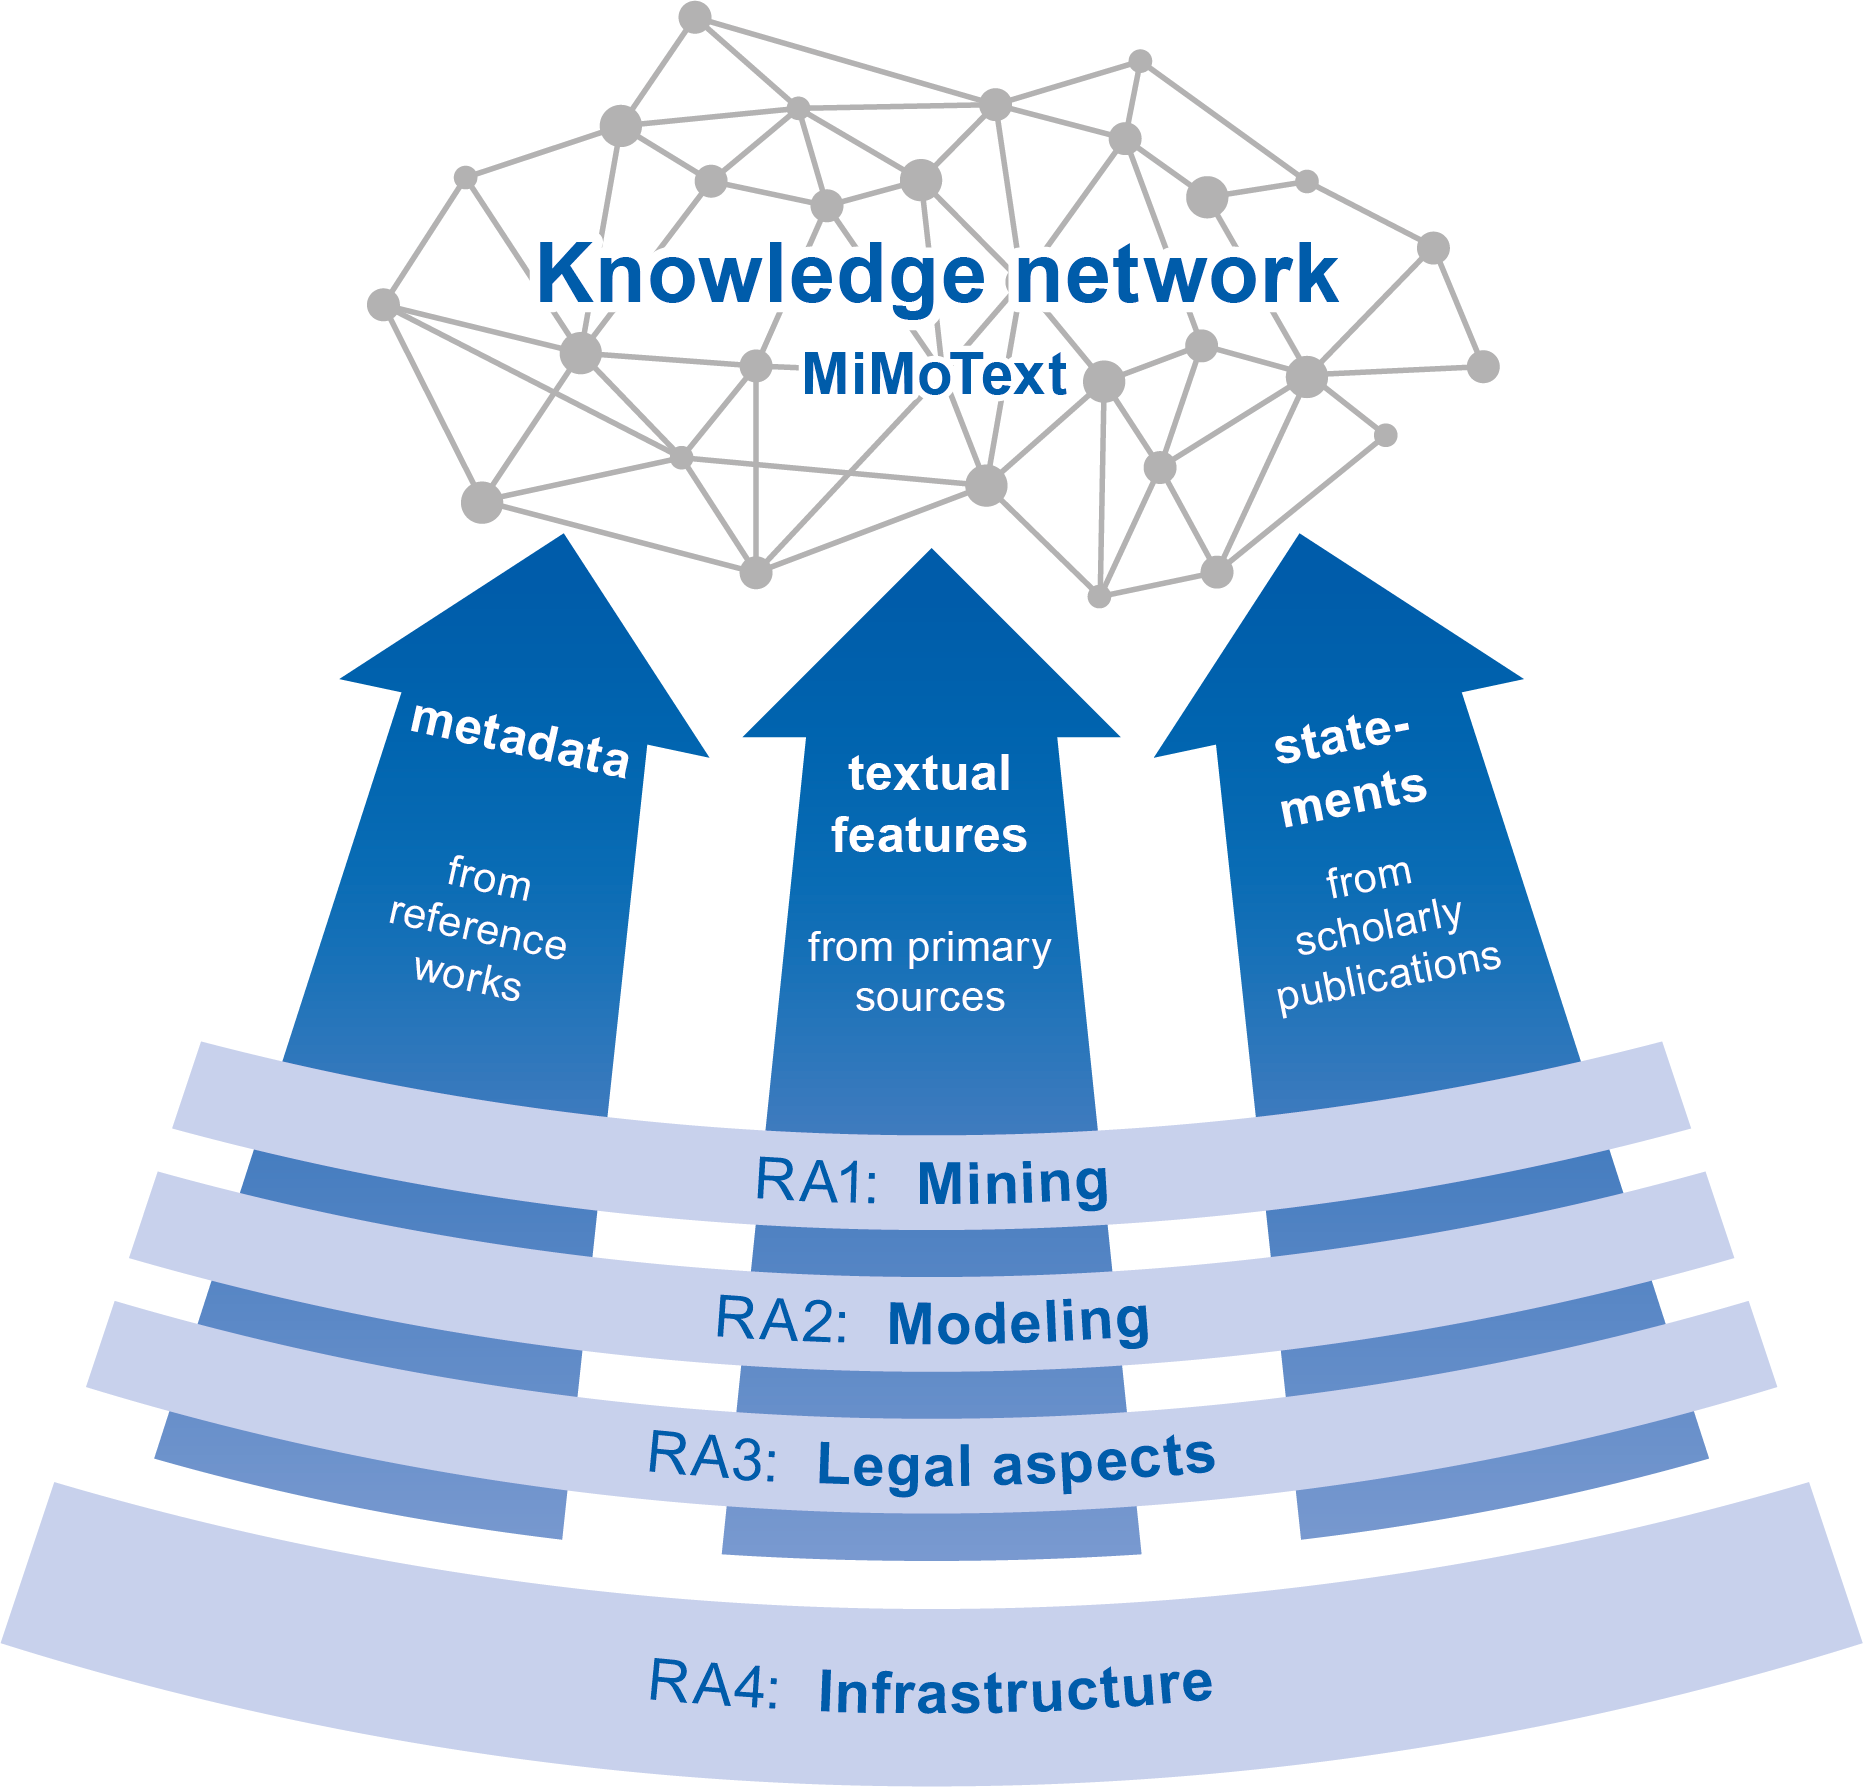
  • 2 – Contexte : Mining and Modeling Text
  • 3 – Création de la base de données
  • 4 – Interfaces donnant accès aux données
    • Les données en RDF
    • L’interface du navigateur
    • L’interface du SPARQL endpoint
    • L’interface fédérée
  • 5 – Exemple : Épistolarité et libertinage
  • 6 – Conclusion : conséquences

Contexte : Mining and Modeling Text

MiMoText, projet interdisciplinaire

  • Projet interdisciplinaire : littérature, humanités numériques, informatique
  • Coordination : ‘Trier Center for Digital Humanities’ (Université de Trèves)
  • Financement : région de la Rhénanie-Palatinat (Forschungsinitiative)
  • Objectif : expérimenter une approche ‘data-driven’ de l’histoire littéraire
  • Réalisation : base de données Wikibase / linked open data
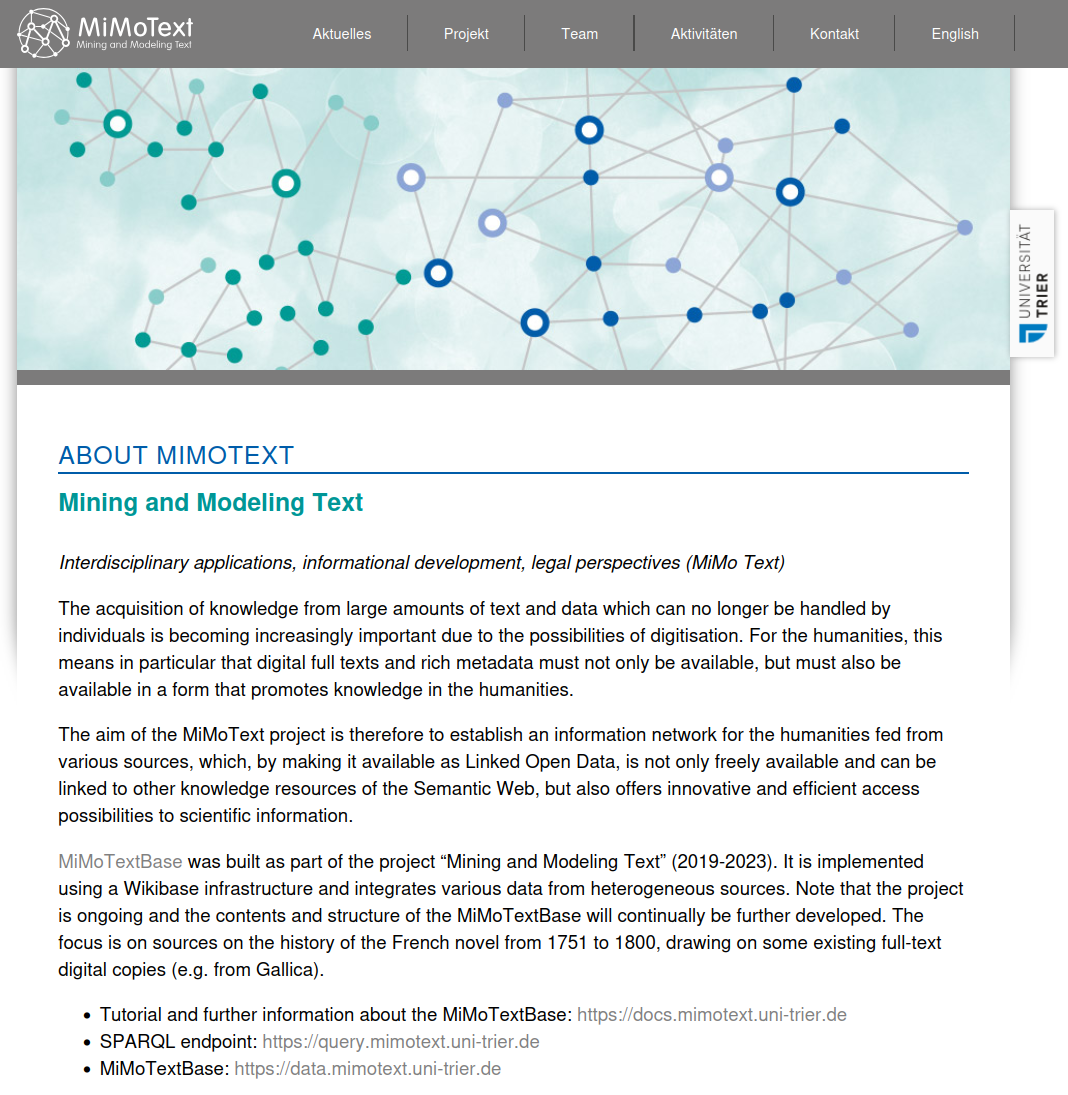
MiMoText : projet collaboratif, merci à tou(te)s !
Création de la base de données

Aperçu général de ‘MiMoText’

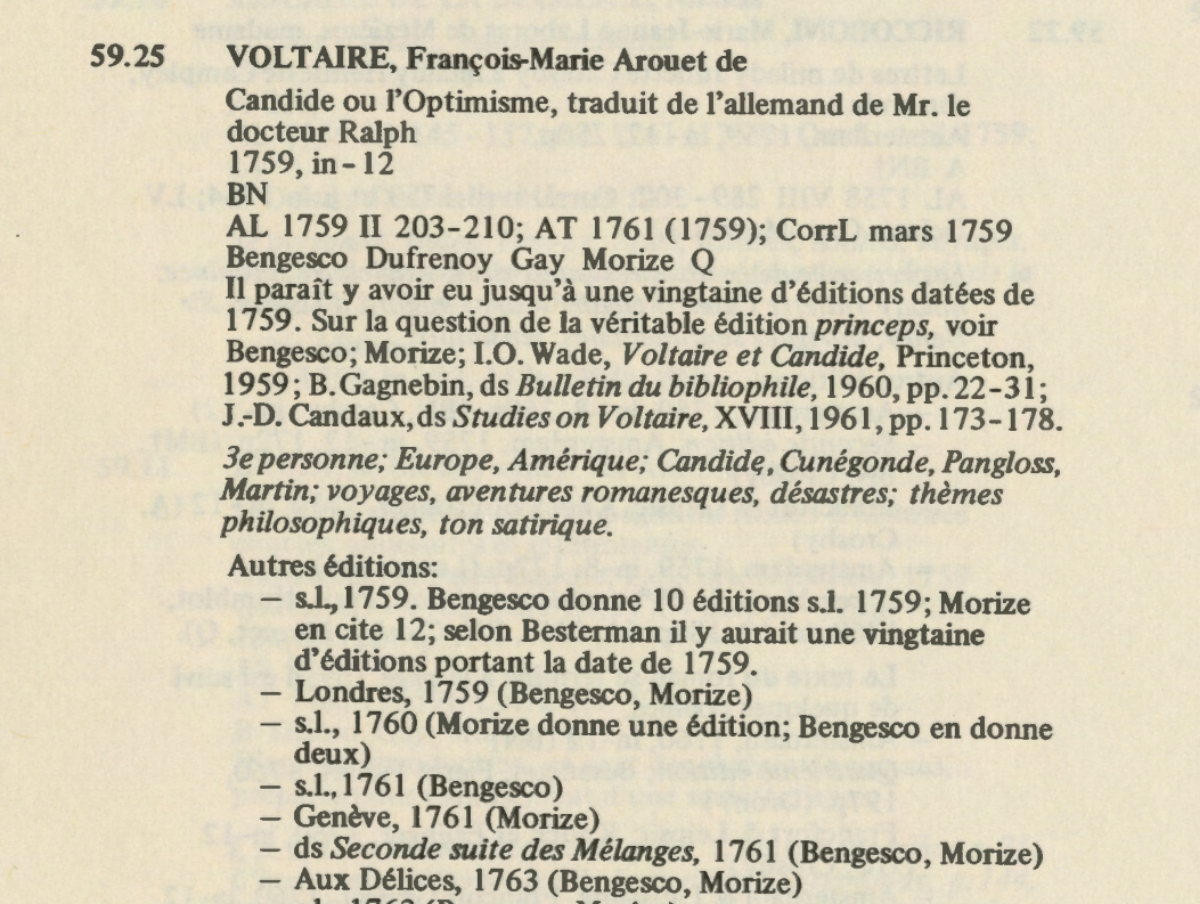
Pilier 1 : La Bibliographie du genre romanesque français
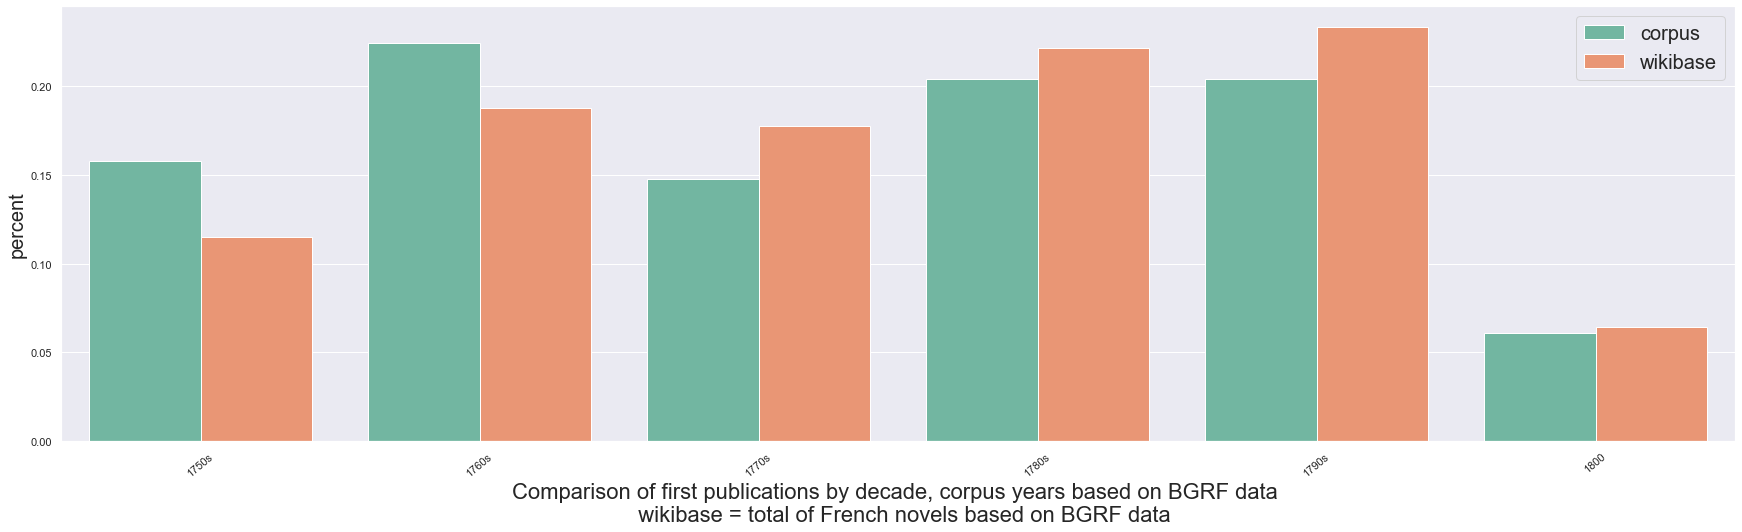
Pilier 2 : littérature primaire (200 romans, 1750–1800)
  • En partie : double-keying => modèle OCR => texte intégral
  • Encodage : en XML-TEI, avec métadonnées (conforme au schéma ELTeC)
  • Méthodes d’analyse : Topic modeling, stylométrie, entités nommées etc.

Pilier 3 : Ouvrages d’histoire littéraire
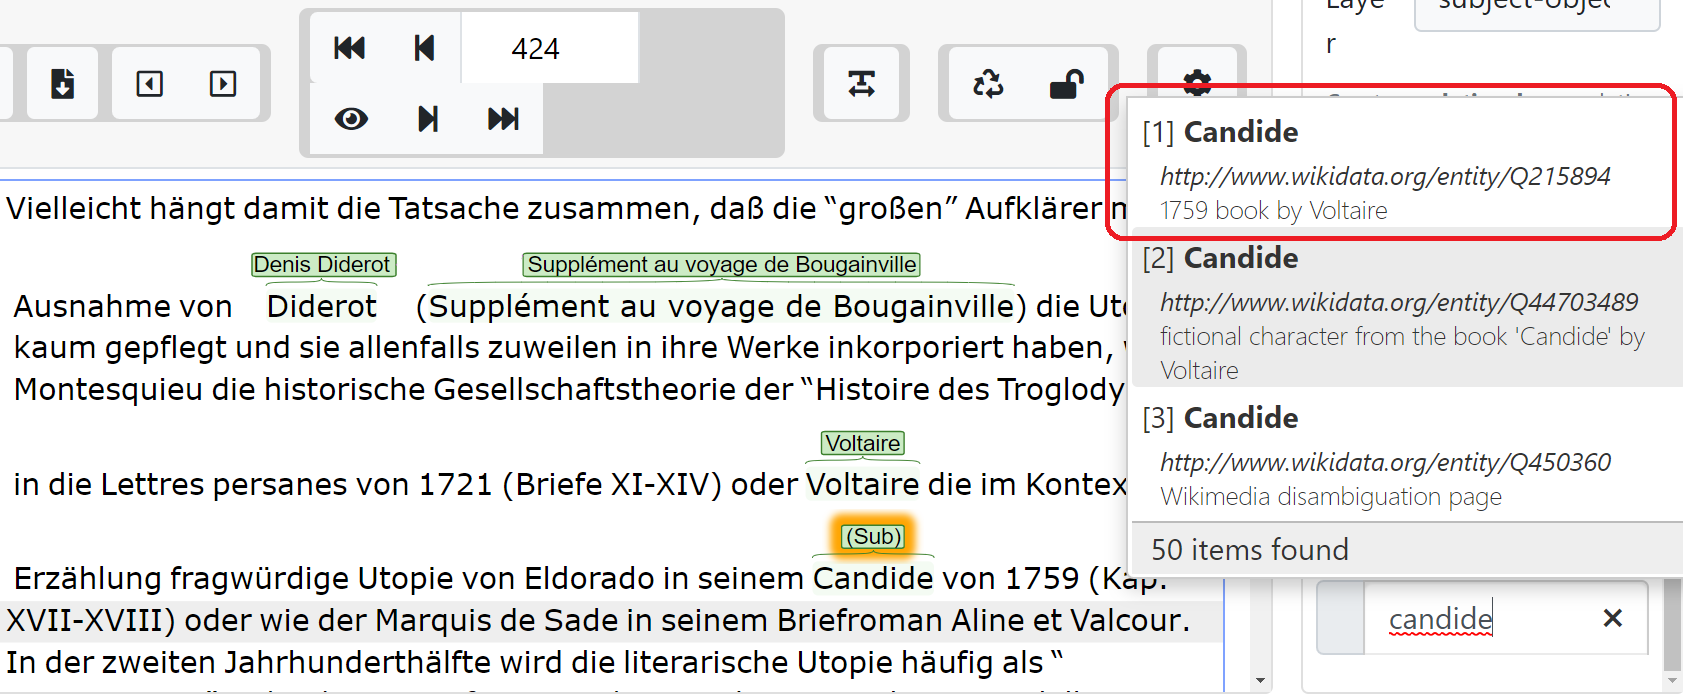
  • Corpus de chapitres sur le roman des Lumières
  • Guide d’annotation => annotations manuelles (avec INCEpTION)
  • Intégration de MiMoTextBase et/ou Wikidata => identification des entités
  • Création de triplets sur les auteurs et les romans (genres, thèmes, etc.)
  • (Machine learning sur les données annotées…)

Modélisation sémantique des résultats en LOD

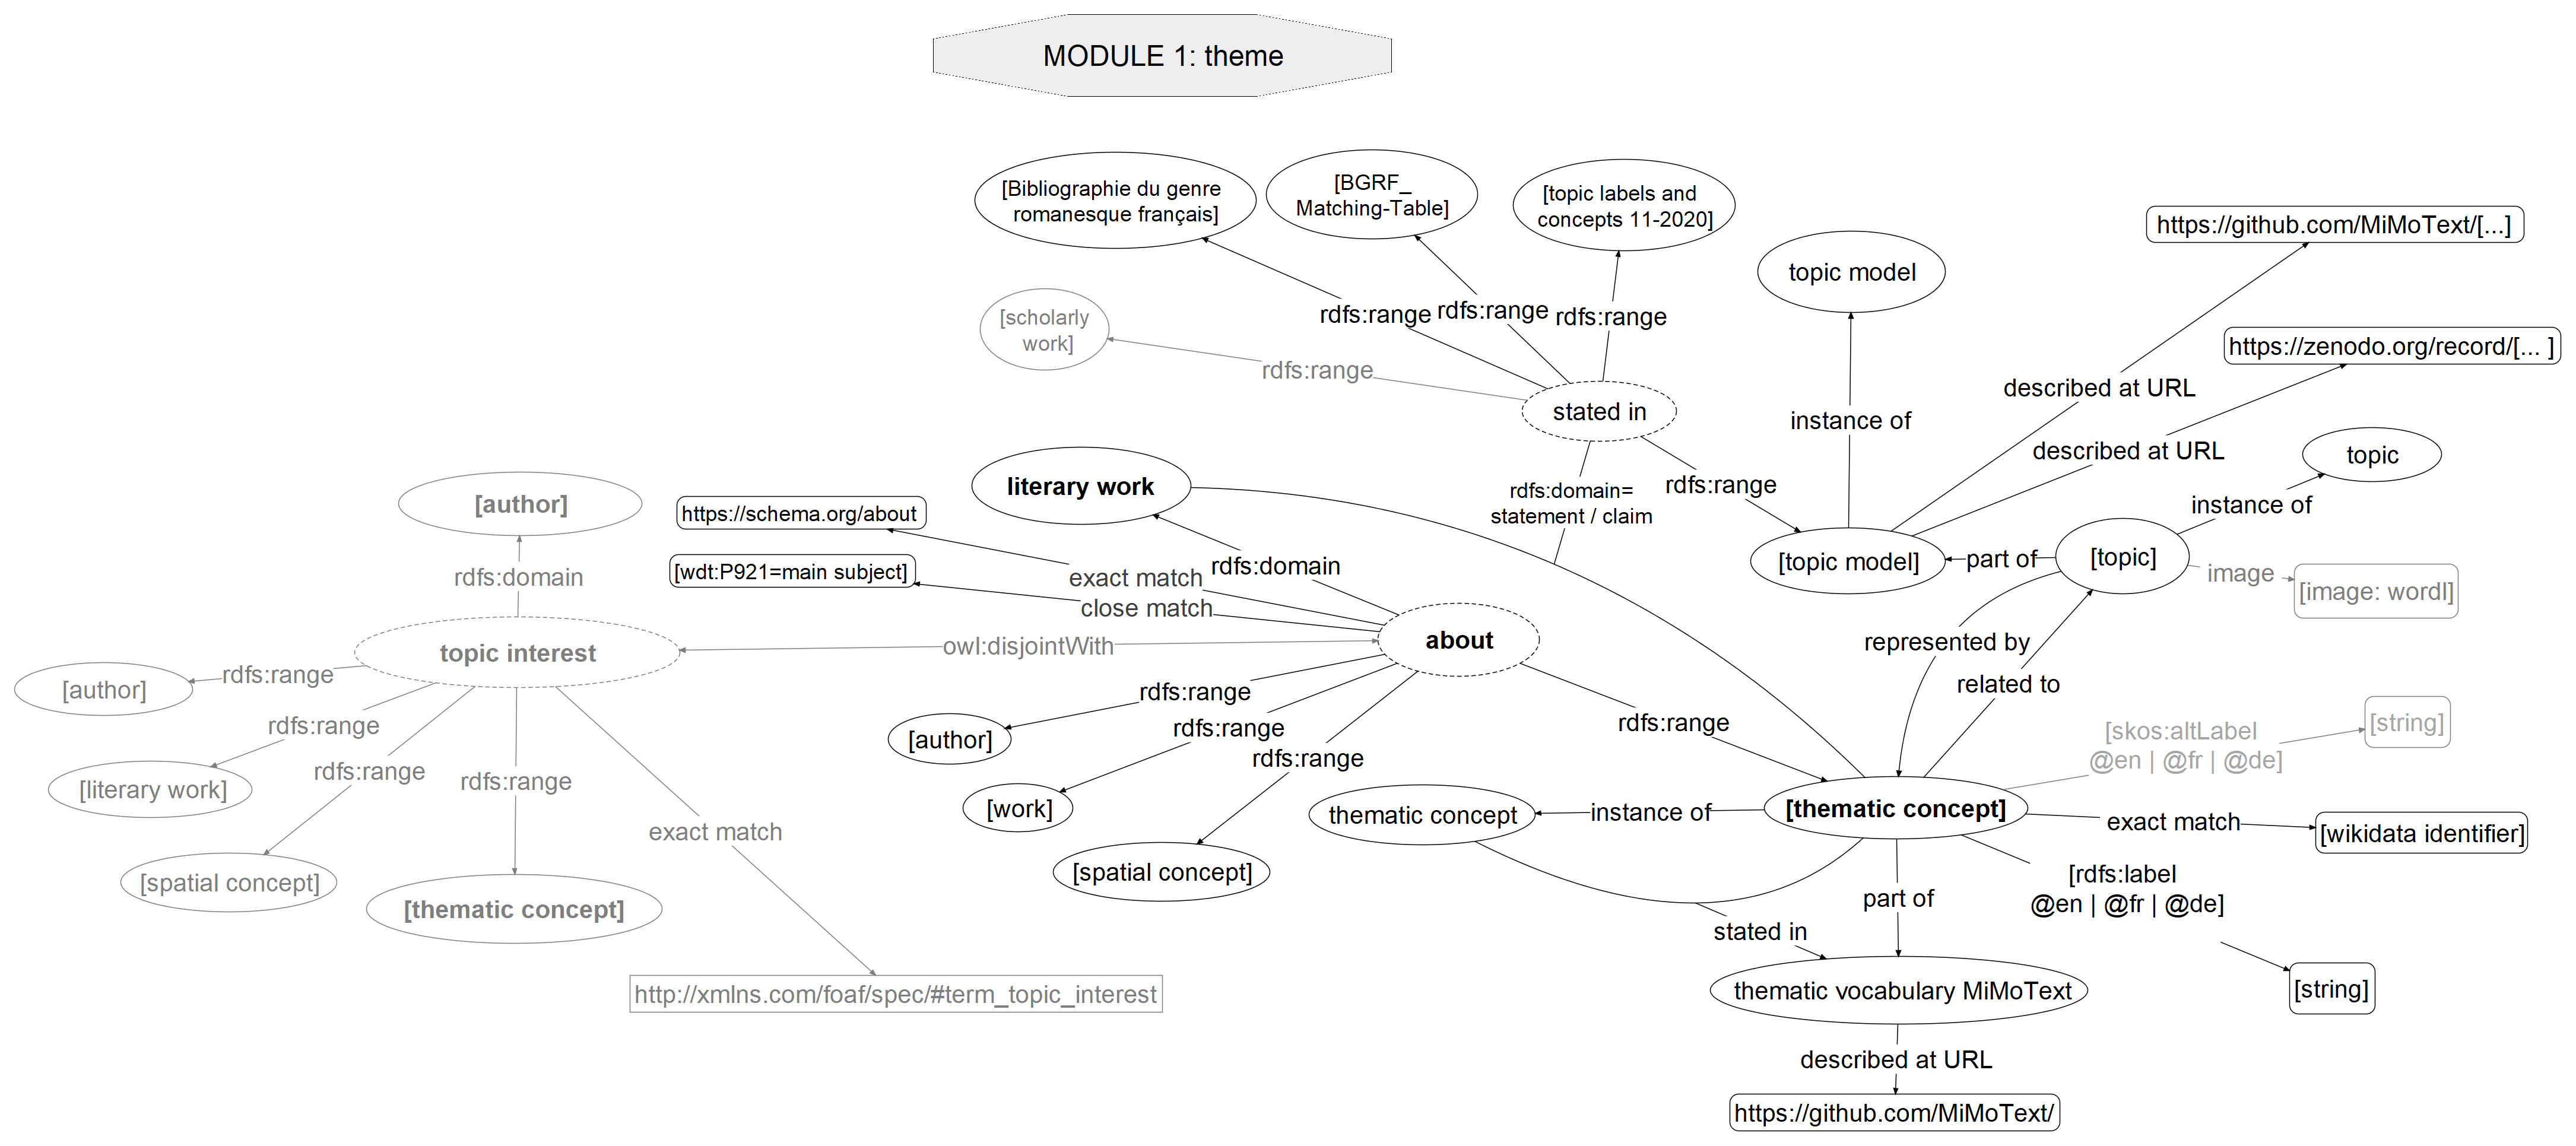
  • Module 1: Thèmes
  • Module 2: Espaces
  • Module 3: Formes narratives
  • Module 4: Oeuvres littéraires
  • Module 5: Auteurs
  • Module 6: Mapping
  • Module 7: Références
  • Module 8: Versions & publication
  • Module 9: Terminologie
  • Module 10: Bibliographie
  • Module 11: Scholarly publications

Interfaces


(1) Les données modélisées en RDF

Fragment du ficher RDF format Turtle (sur Aline et Valcour)

wd:Q1085 a wikibase:Item ;
    wdt:P22 "95.36" ;
    wdt:P5 wd:Q855 ;
    wdt:P4 "Aline et Valcour ou le roman philosophique, écrit à la Bastille un an avant la Révolution de France, orné de quatorze gravures, par le citoyen S***"@fr ;
    wdt:P24 "Girouard"@fr,
        "Paris"@fr ;
    wdt:P9 "1795-01-01T00:00:00Z"^^xsd:dateTime ;
    wdt:P23 "1793  Bien que portant la date de 1793, cet ouvrage ne fut publie qu'en 1795."@fr ;
    wdt:P26 "8t. en 4 v. in-18"@fr ;
    wdt:P25 "xiv + 315, 503, 575, 374p."@fr ;
    wdt:P27 "Lettres, avec récits intercalés 1re personne"@fr ;
    wdt:P28 "Paris, province, royaume de Butua"@fr ;
    wdt:P29 "Déterville, Valcour; Eugénie, Aline"@fr ;
    wdt:P30 "aventures romanesques, voyages, libertinage"@fr ;
    wdt:P31 "horreur et cruauté"@fr ;
    wdt:P2 wd:Q2 ;
    wdt:P12 wd:Q12 ;
    wdt:P36 wd:Q2969,
        wd:Q3126,
        wd:Q3039,
        wd:Q2952,
        wd:Q2776,
        wd:Q3087,
        wd:Q2864,
        wd:Q2988 ;
    wdt:P33 wd:Q42 ;
    wdt:P32 wd:Q3521,
        wd:Q3243,
        wd:Q3776,
        wd:Q3497 ;
    wdt:P21 <https://github.com/MiMoText/roman18/blob/master/plain/files/Sade_Aline.txt>,
        <https://github.com/MiMoText/roman18/blob/master/XML-TEI/files/Sade_Aline.xml>,
        <https://github.com/MiMoText/roman18/blob/master/plain/files_non_modernized/Sade_Aline.txt> ;
    wdt:P10 wd:Q3521 ;
    wdt:P40 "+297960"^^xsd:decimal ;
    wdt:P13 <http://www.wikidata.org/entity/Q629452> ;
    p:P22 s:Q1085-b985e0cd-f8a1-4b83-8869-f6ef0ec85719 .


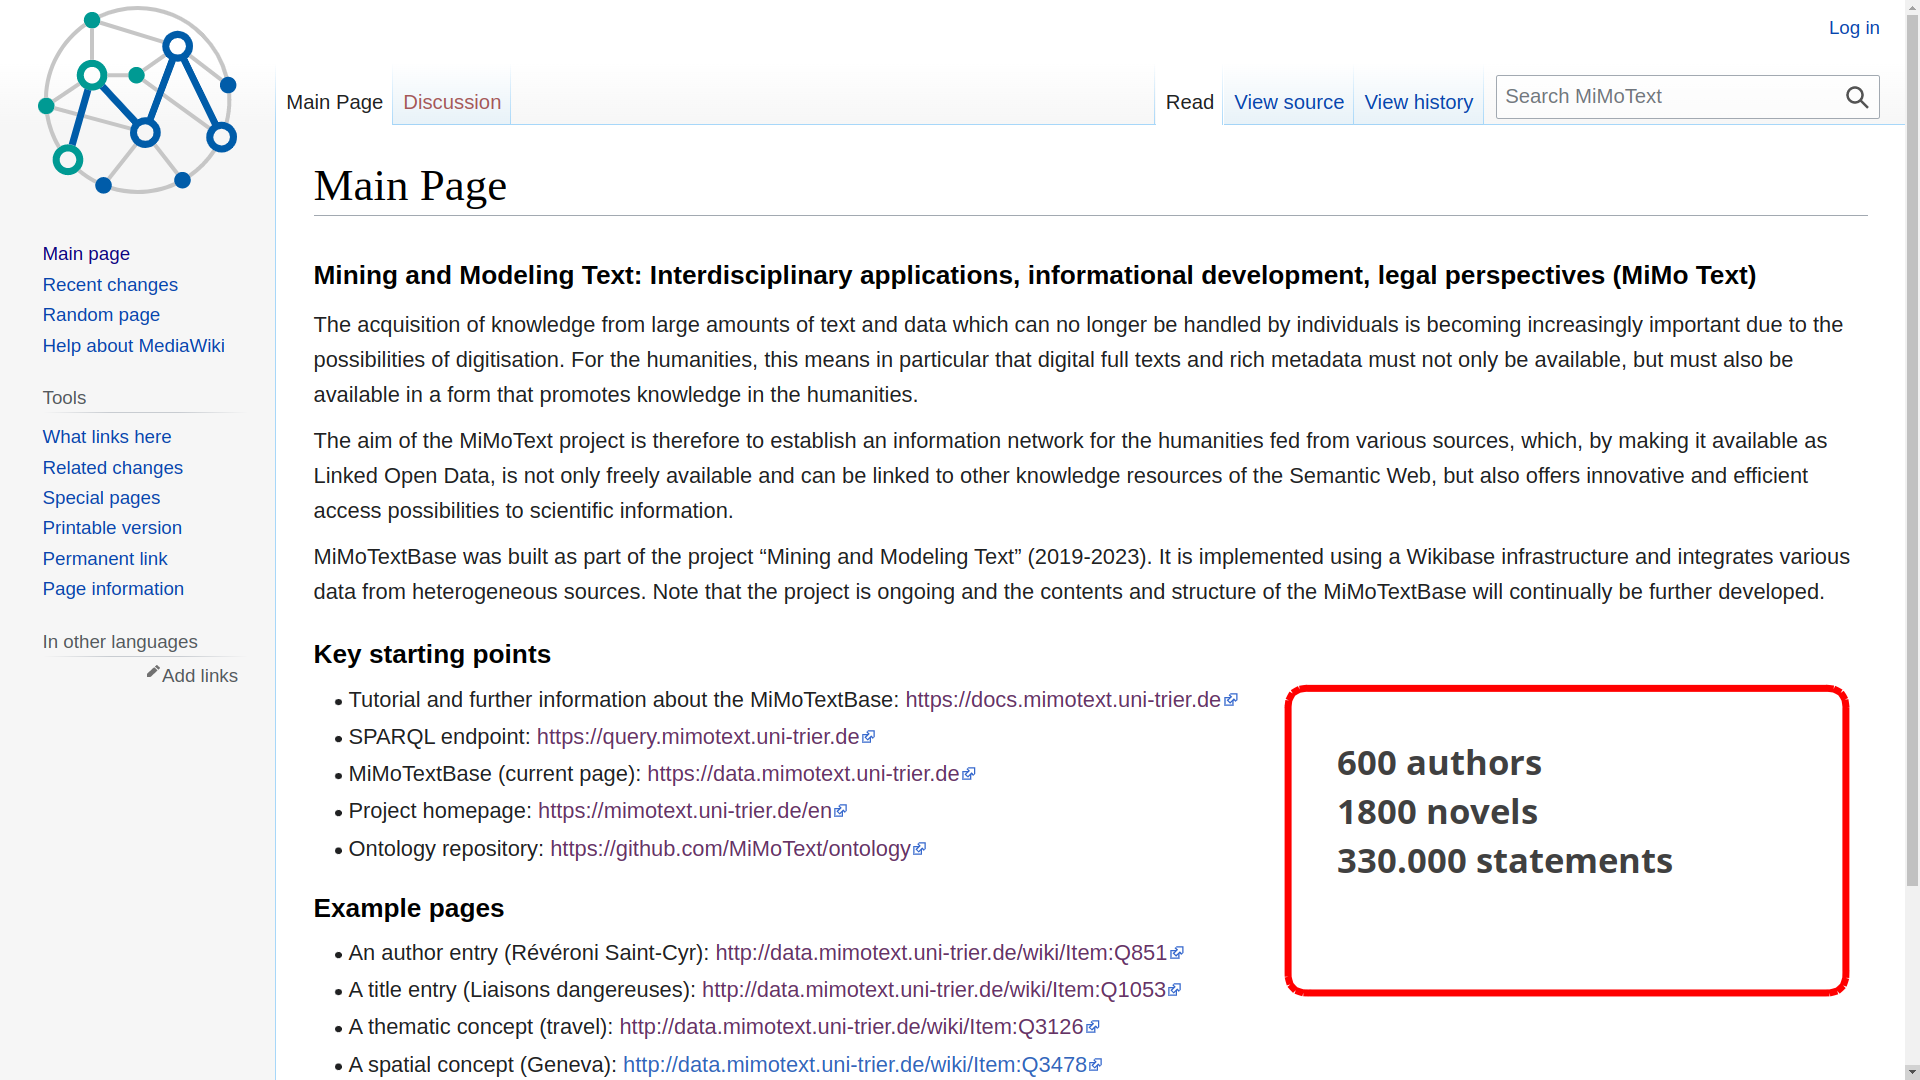
(2) L’interface du navigateur


(2) Accès à travers le SPARQL endpoint

SPARQL : les requêtes comme interface des données

  • PREFIX : la localisation des données
  • SELECT : les informations à rassembler
  • WHERE : les critères de sélection
  • SERVICE : p.ex. les labels (en différentes langues)
  • GROUP BY / ORDER BY (l’ordre des résultats)

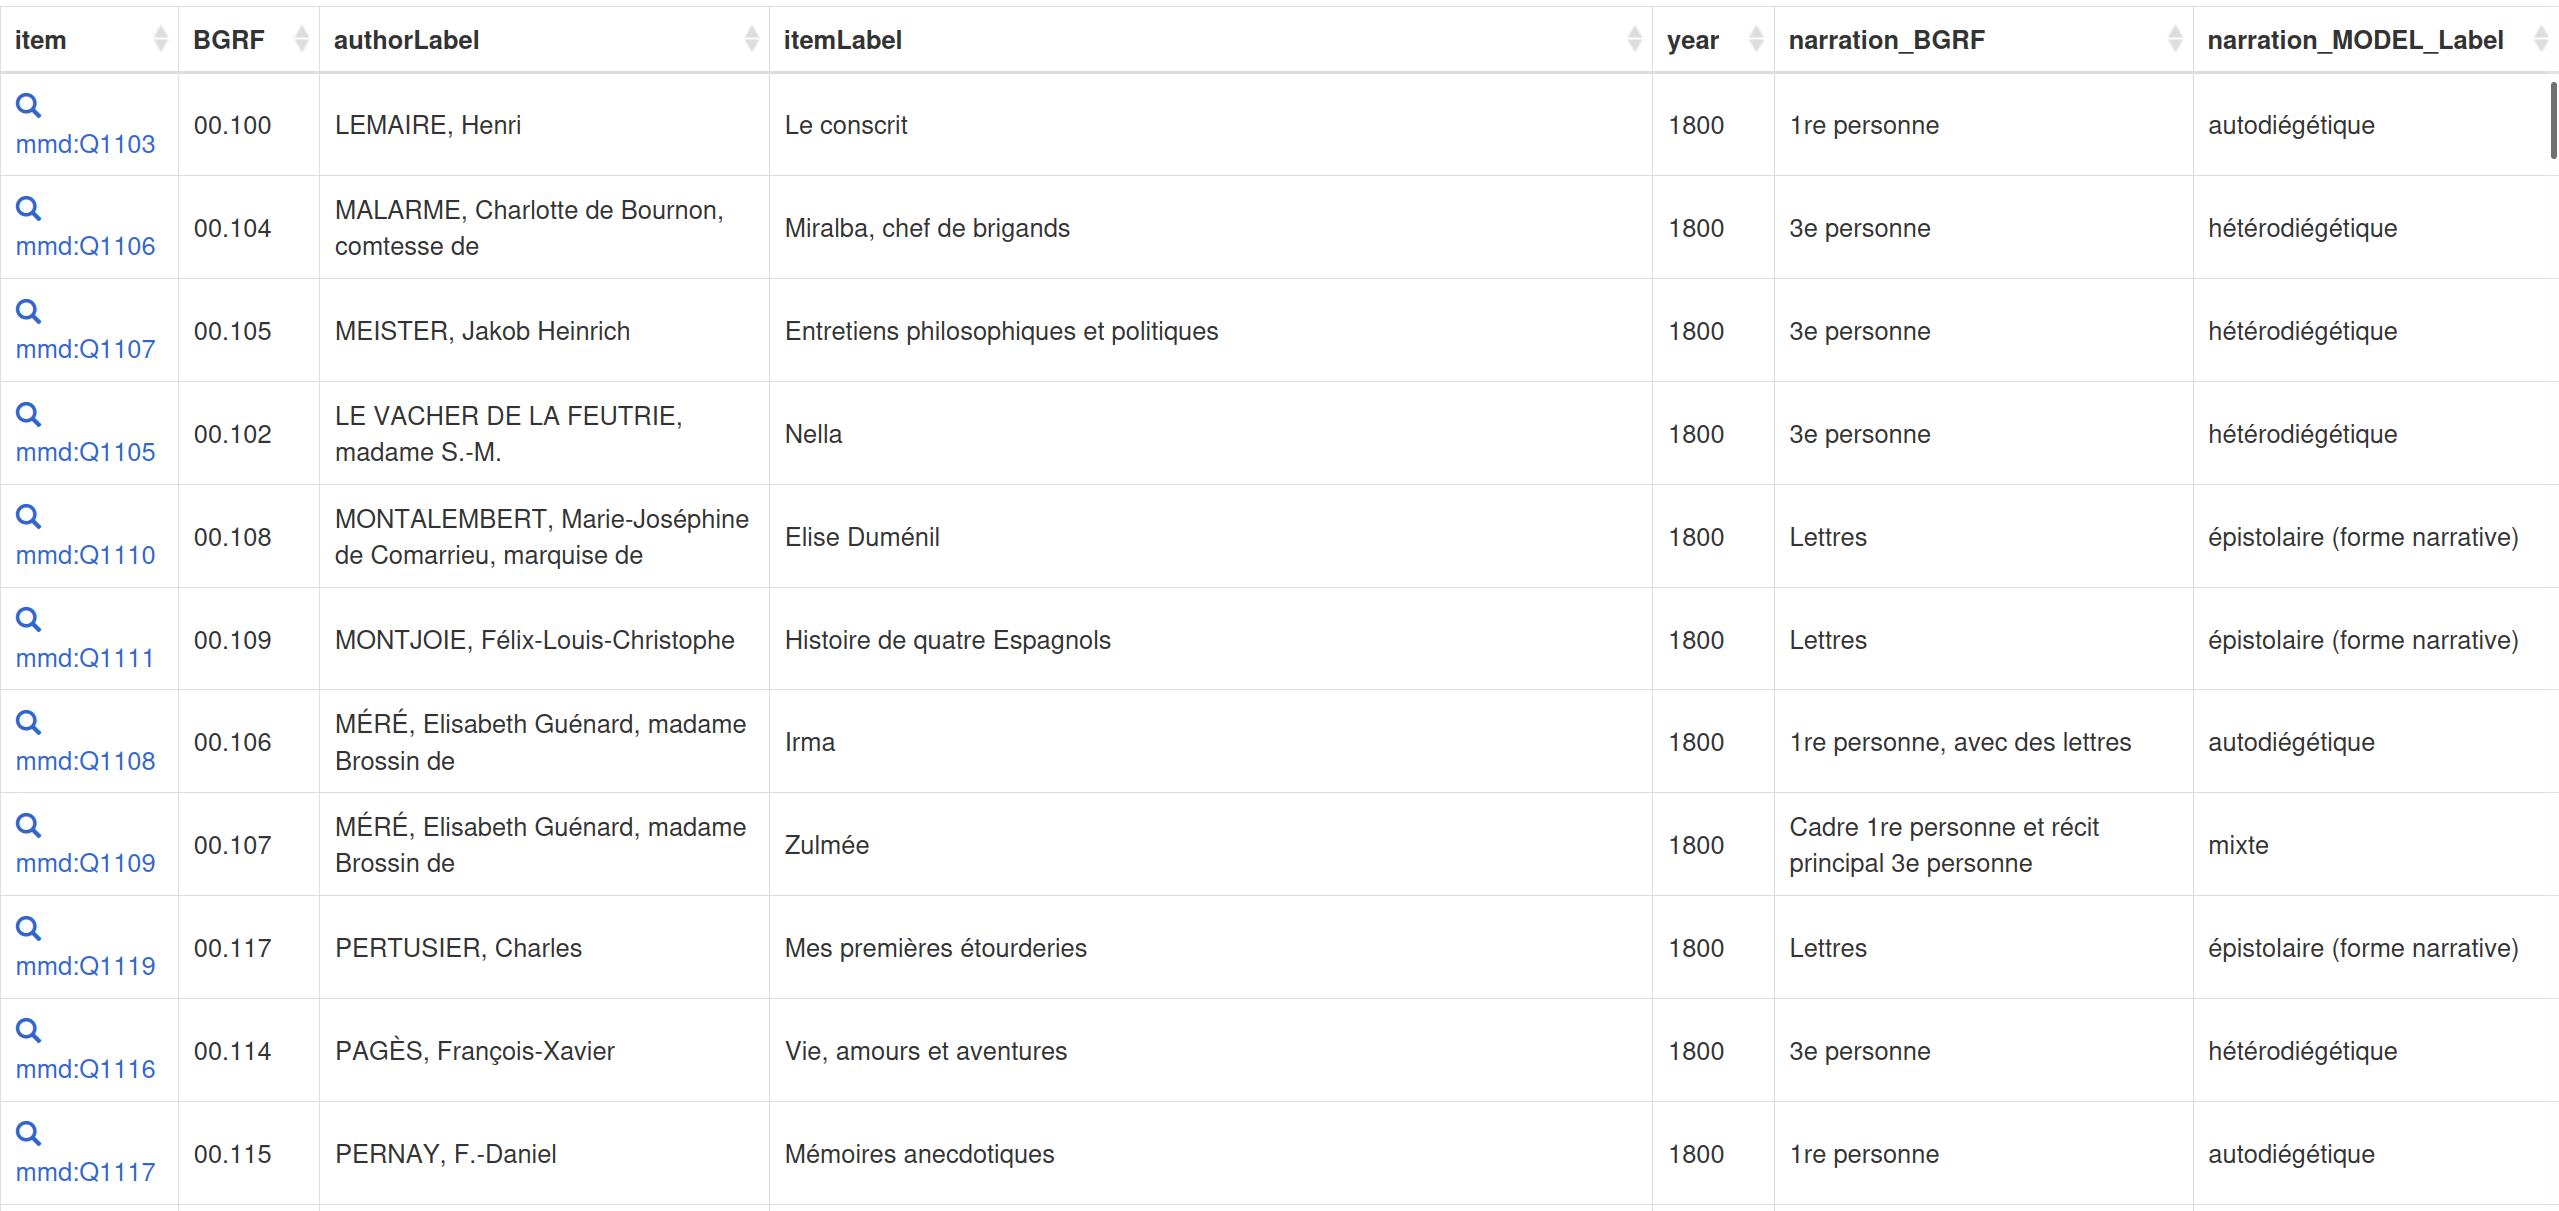
Requête avec tableau des résultats

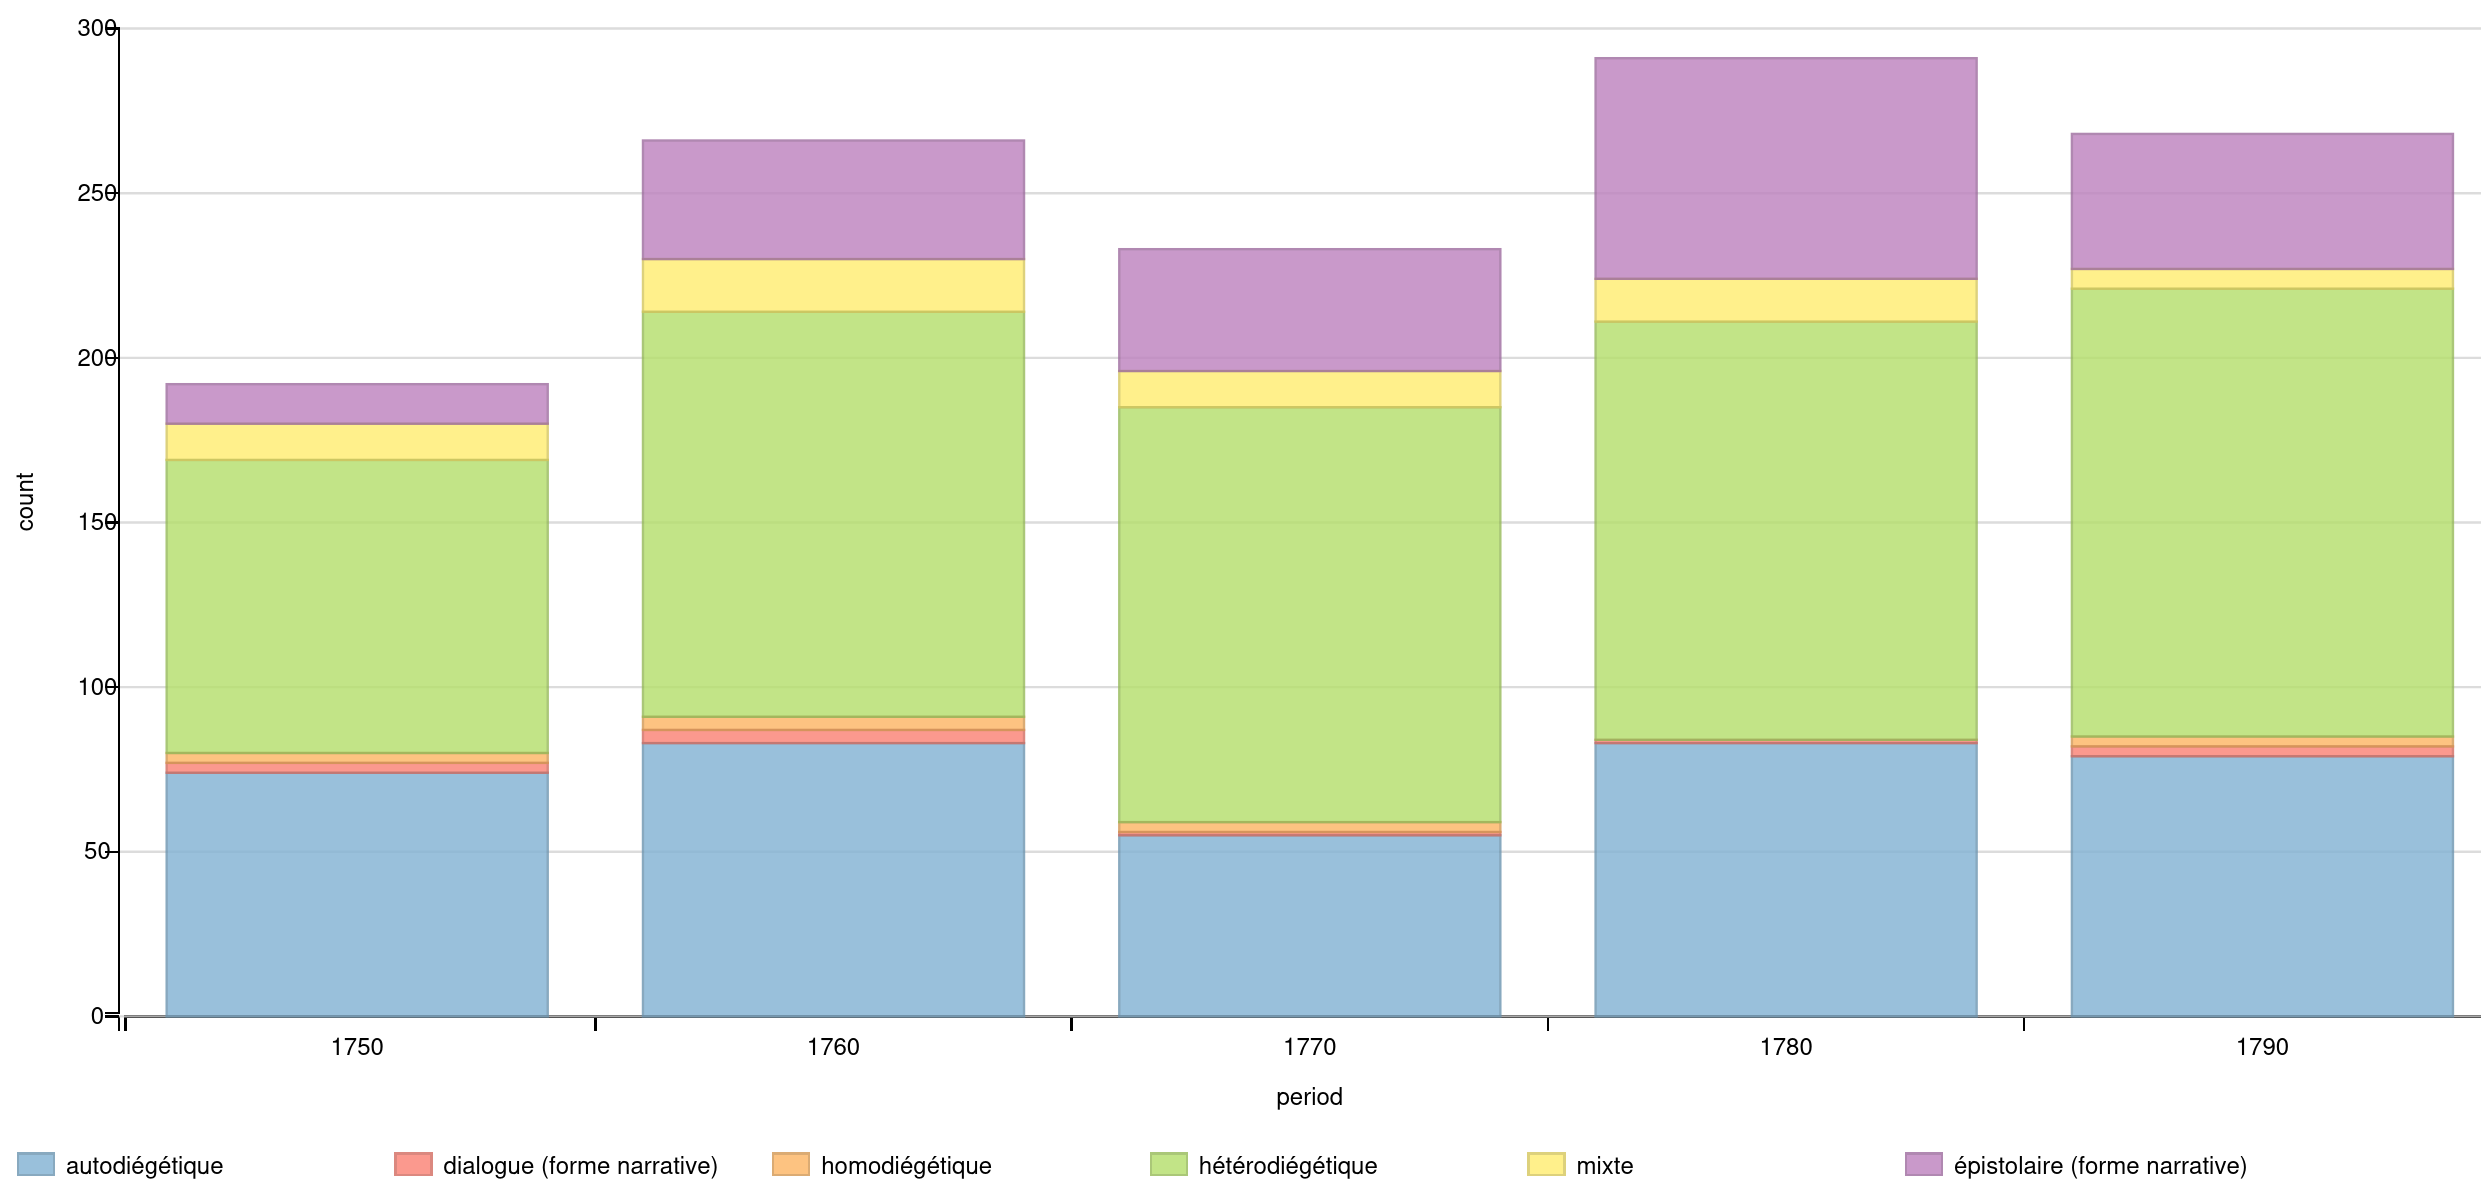
Requête avec visualisation des résultats


(3) L’interface fédérée

Prérequis pour la fédération

  • Fédération simple
    • Données ouvertes avec API (interface technique)
    • Fiches d’autorité (personnes, oeuvres, lieux, thèmes)
    • Mapping d’identifiants
  • Fédération bi-directionelle
    • propriété “MiMoTextID” sur Wikidata
    • MiMoTextBase acceptée par Wikidata

Comment cela fonctionne dans MiMoText

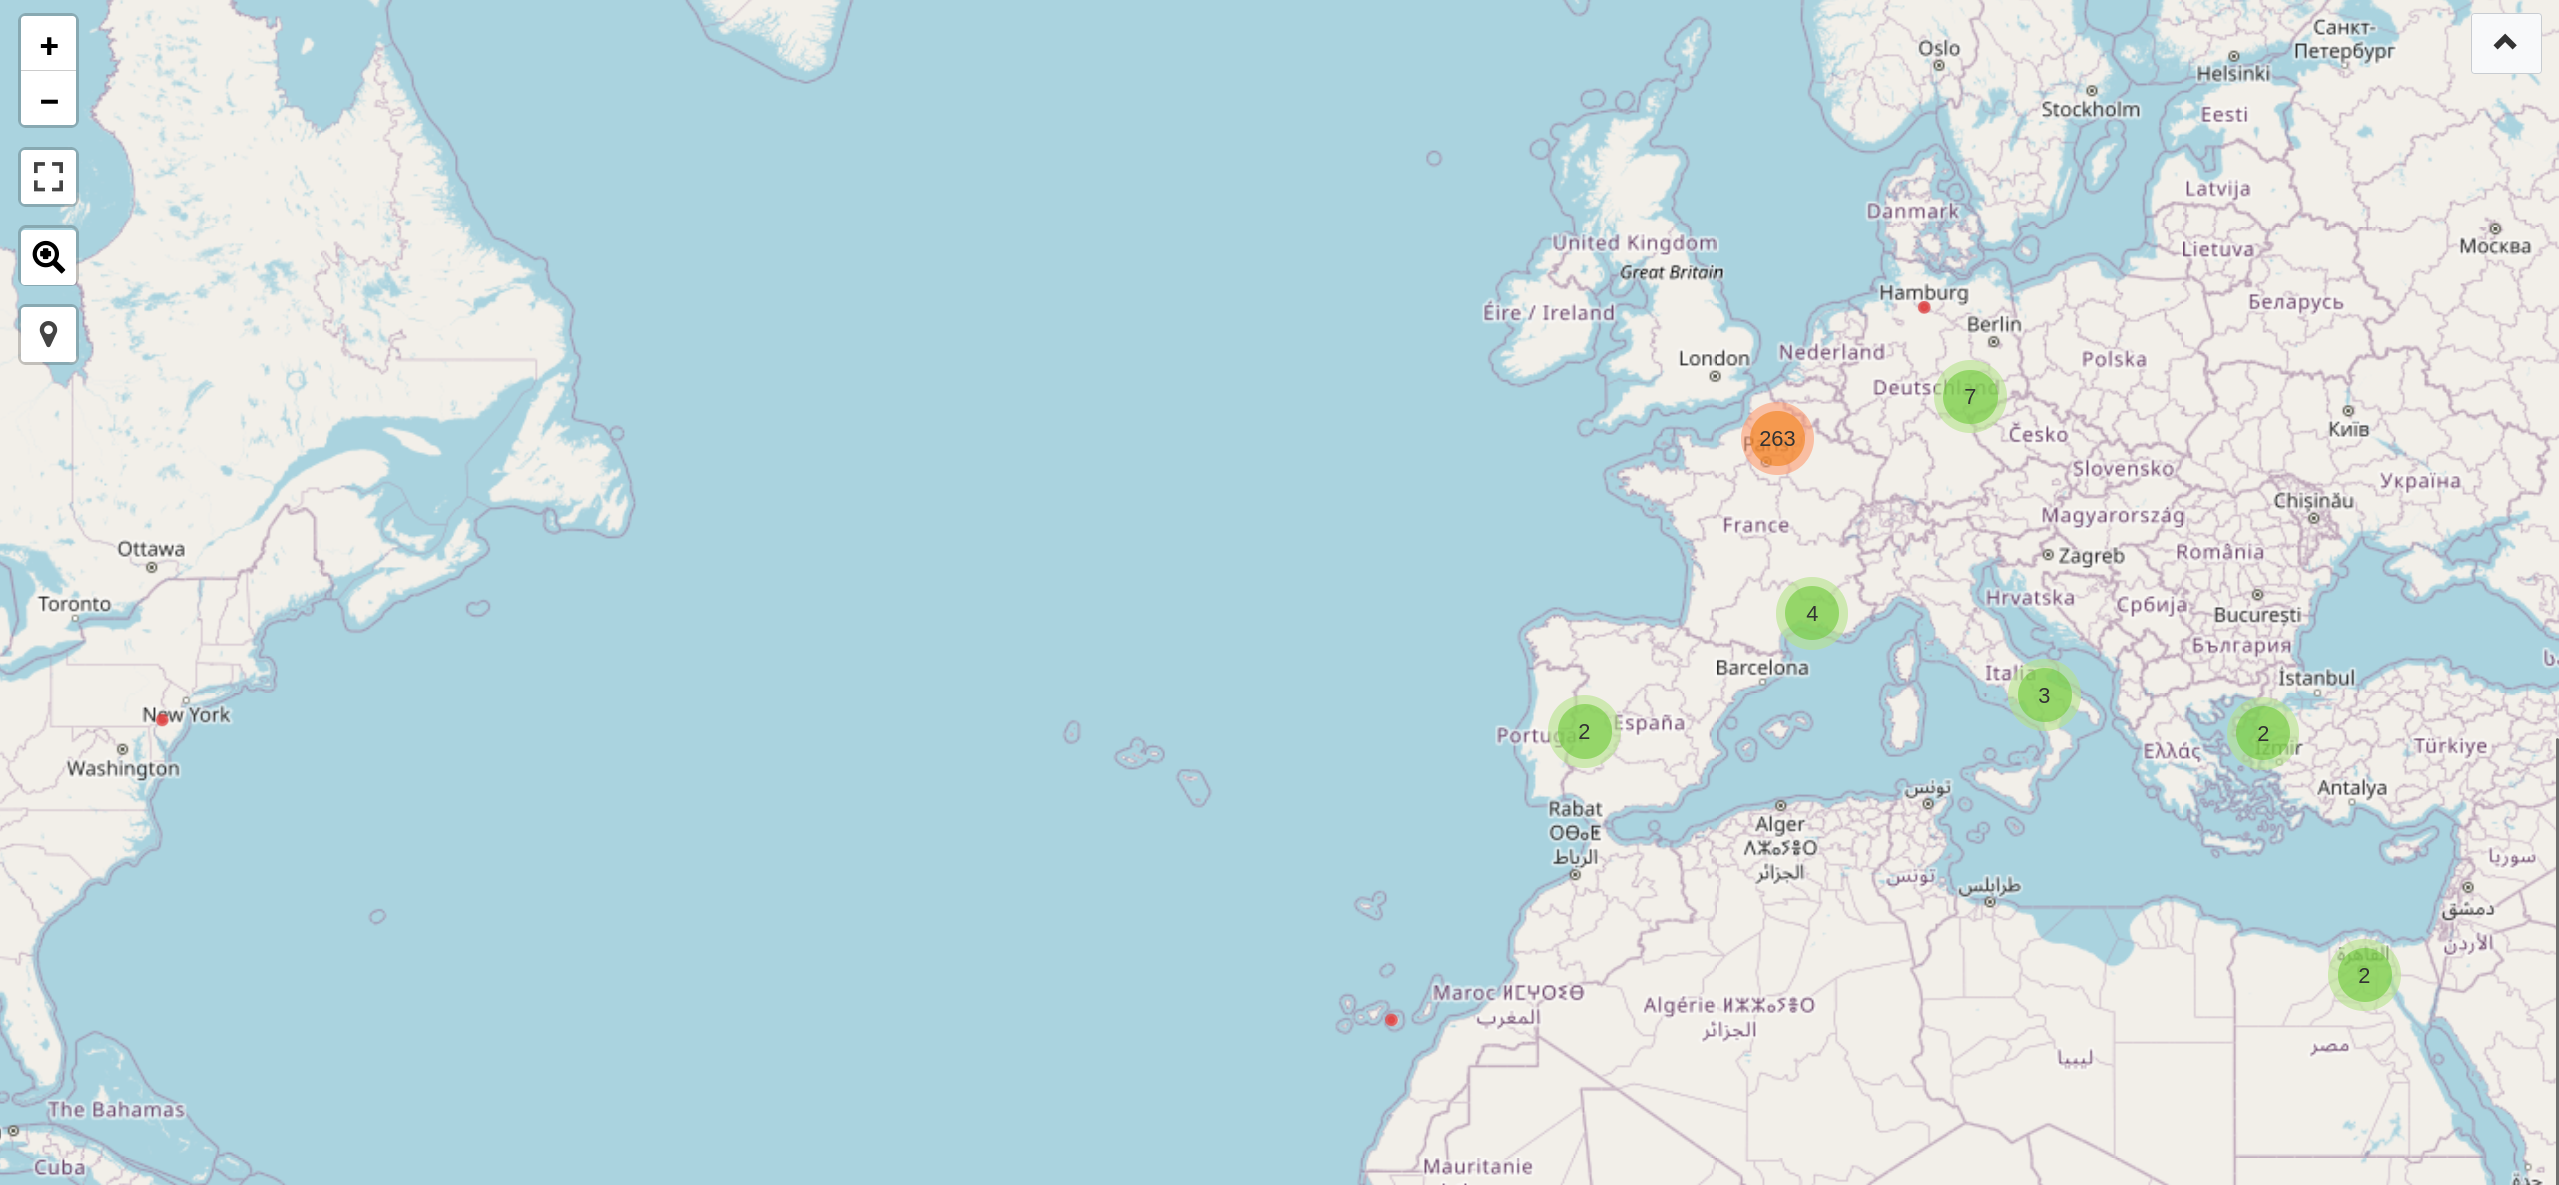
Requête avec fédération : MiMoText => Wikidata
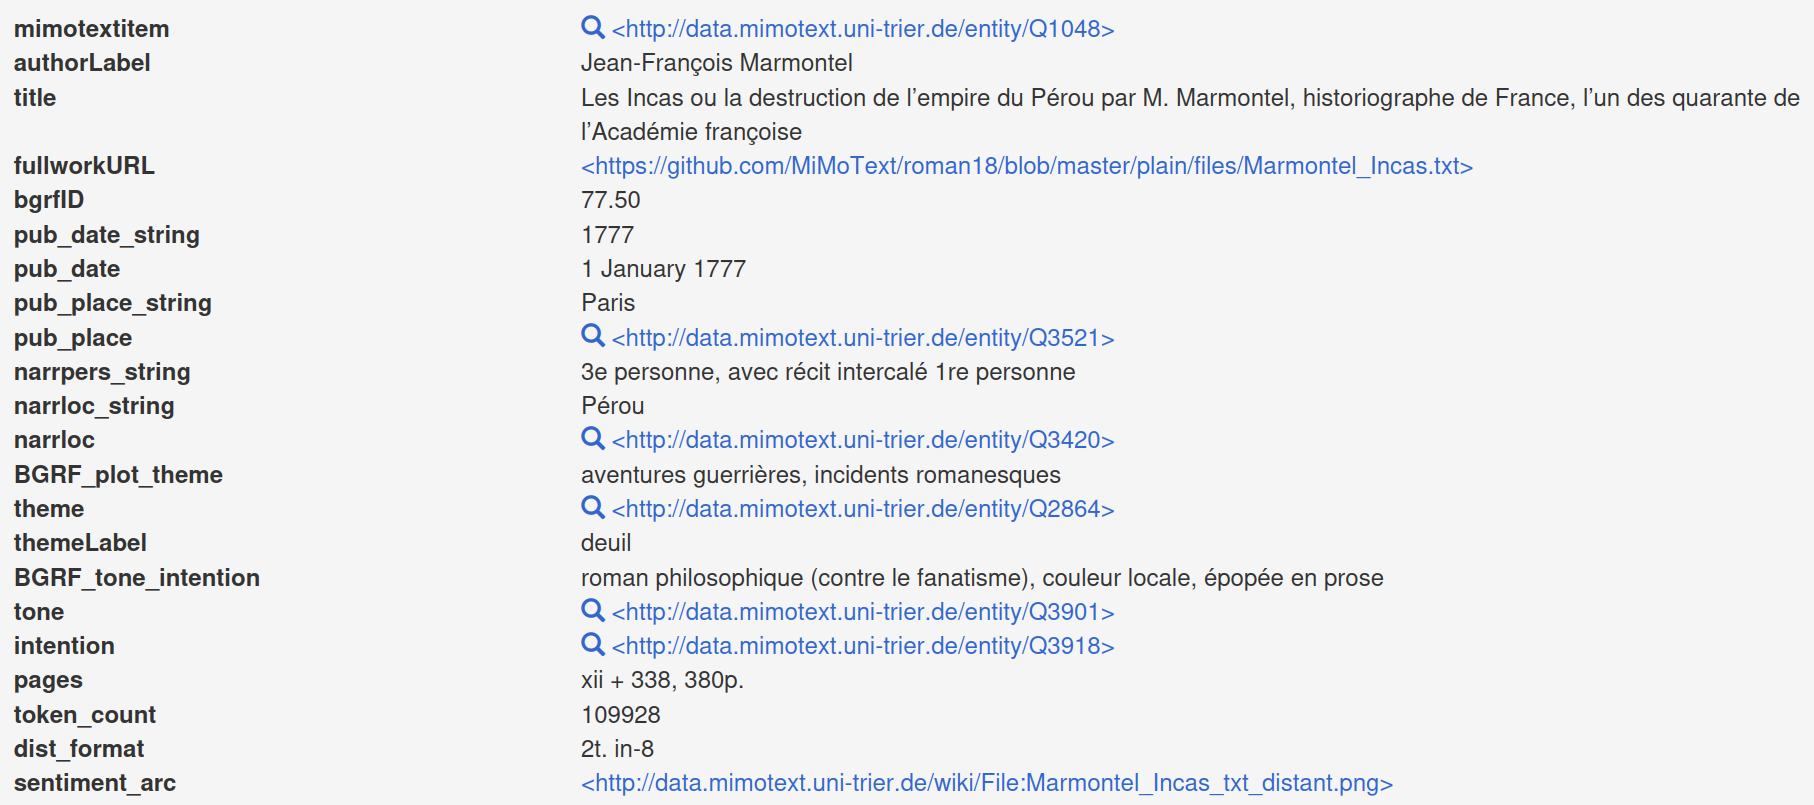
Fédération Wikidata => MiMoText
Exemple : Épistolarité et libertinage

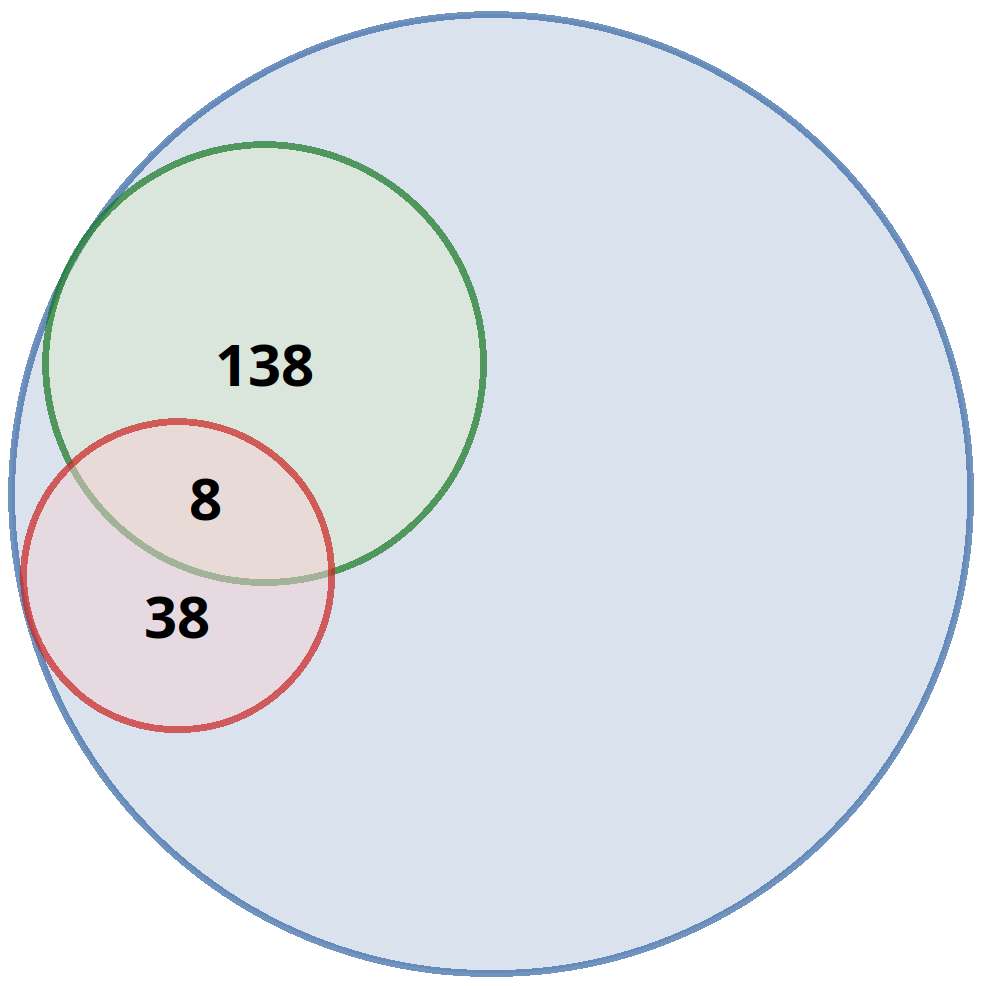
La question : Est-ce qu’il y a un roman épistolaire libertin après 1782 ?

  • van Crugten-André (1997): “le genre épistolaire est à peine représenté dans le roman libertin après Laclos” [=1782]
  • Benoît Melançon (2004): article sur le “roman épistolaire libertain tardif”, c’est-à-dire après 1782.
  • Consensus qu’il y a un lien étroit entre libertinage et épistolarité
  • Mais un manque de clarté sur son extension temporelle exacte
Clarification ? Données de la MiMoTextBase

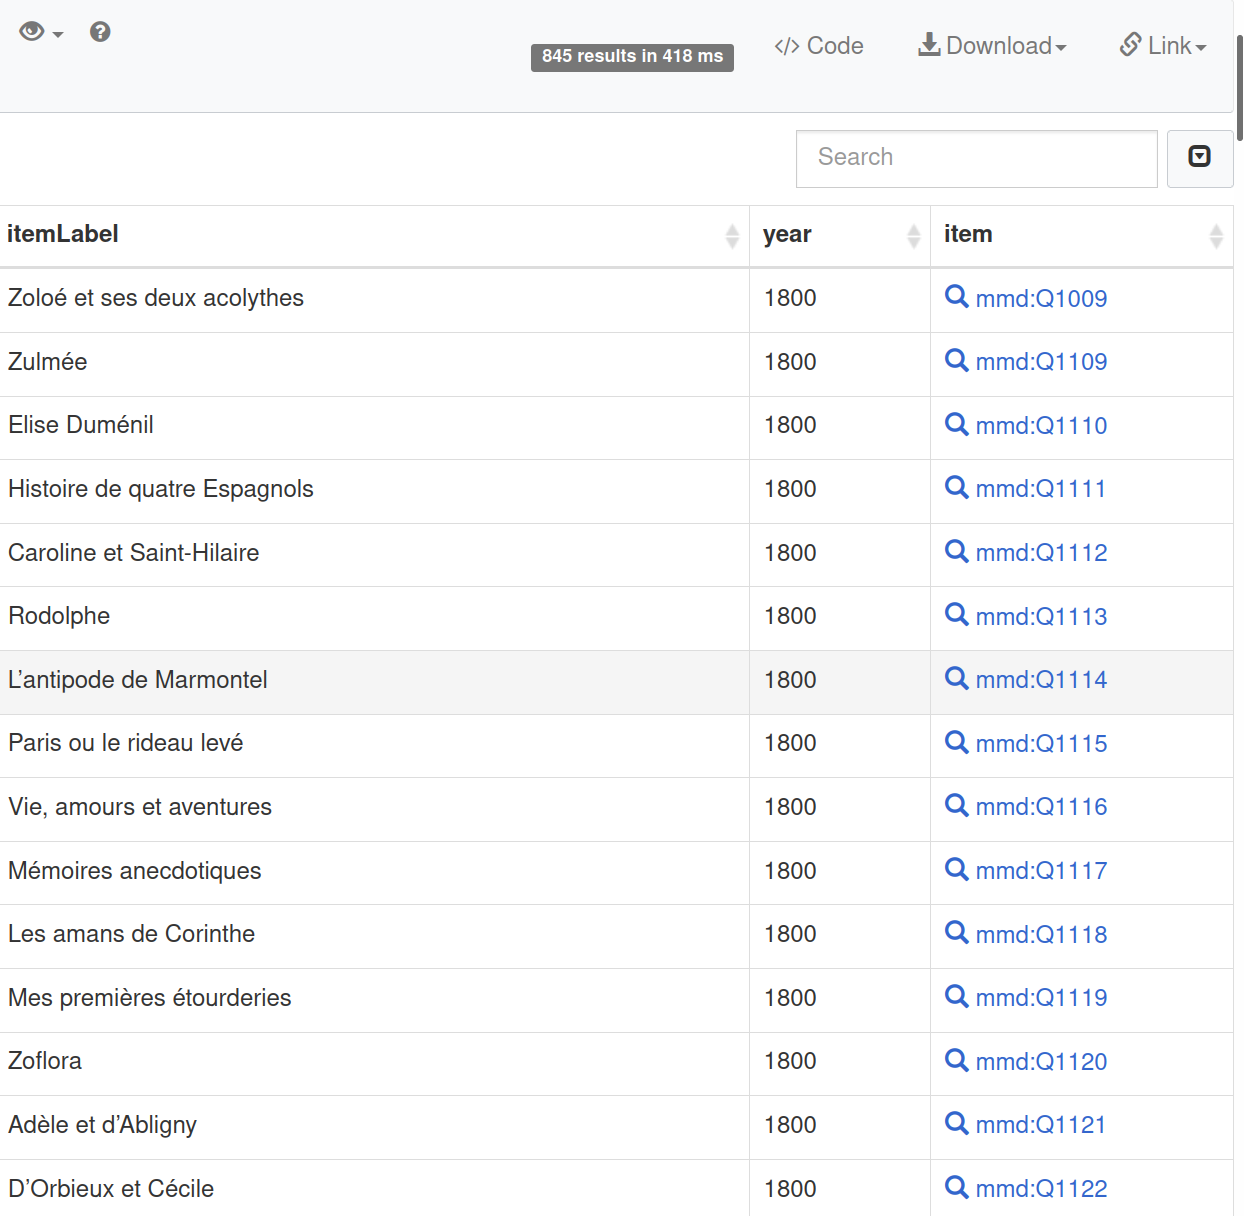
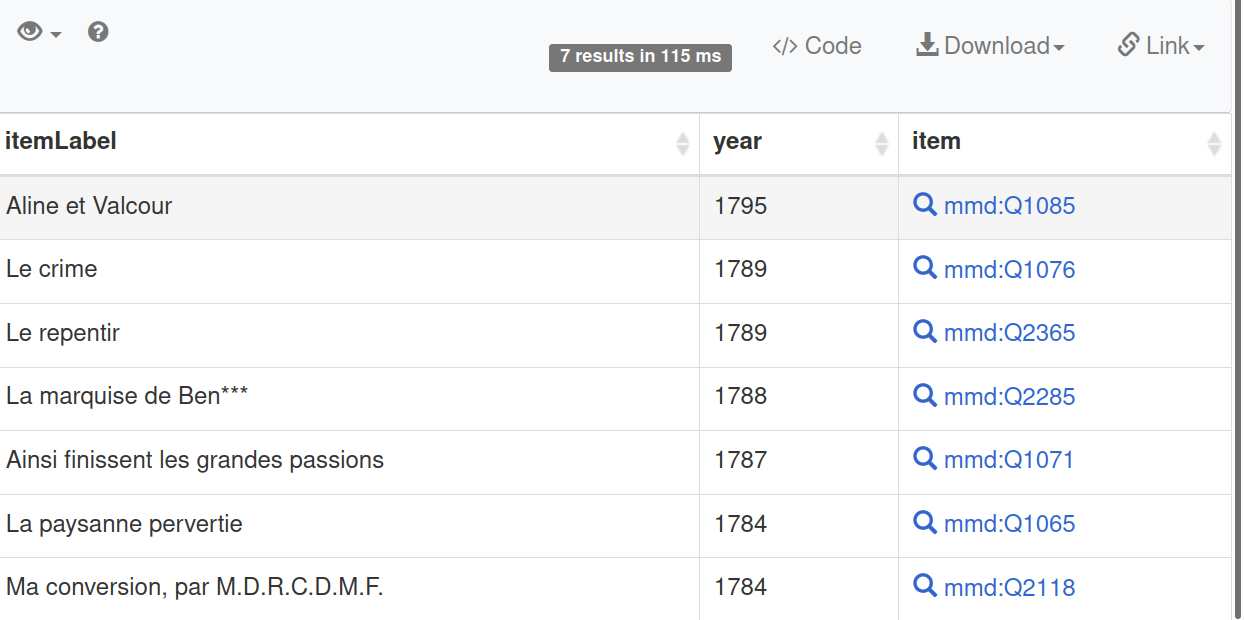
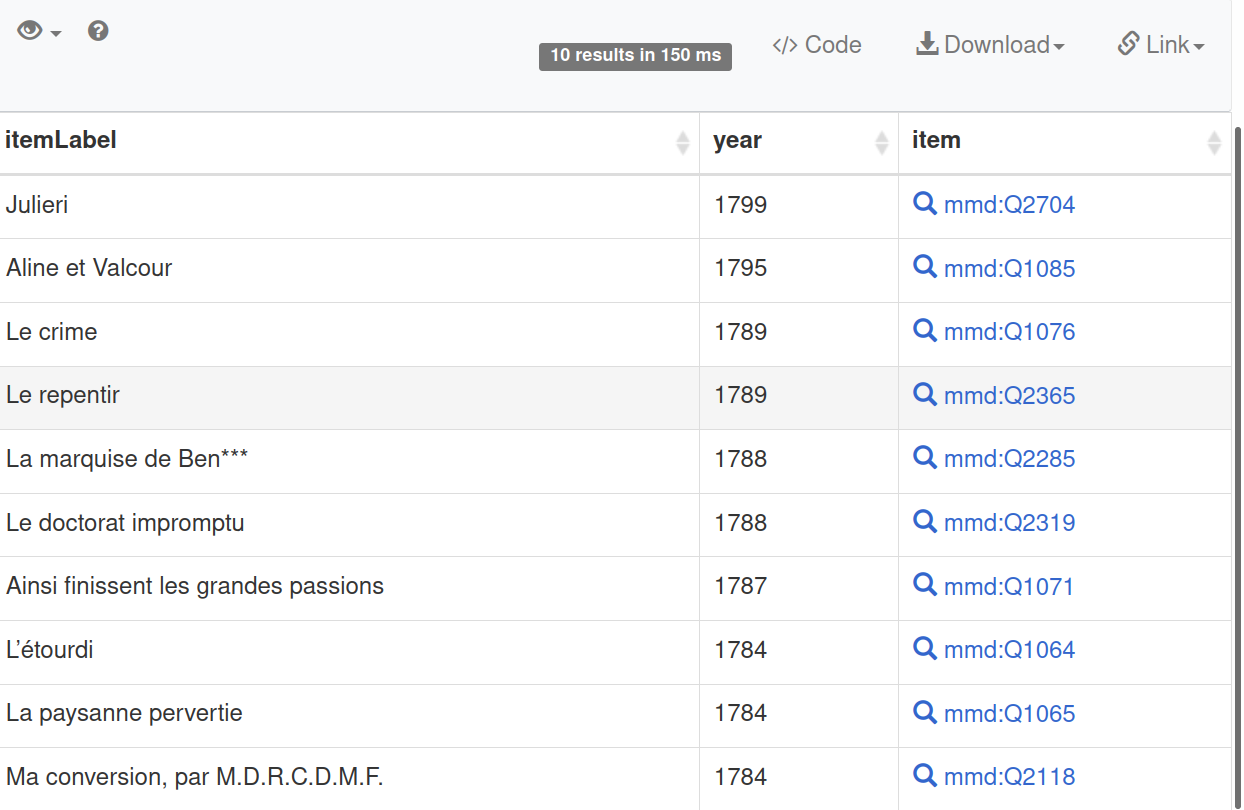
Requête 1 : romans 1782–1800

Requête 2 : Romans épistolaires 1782–1800
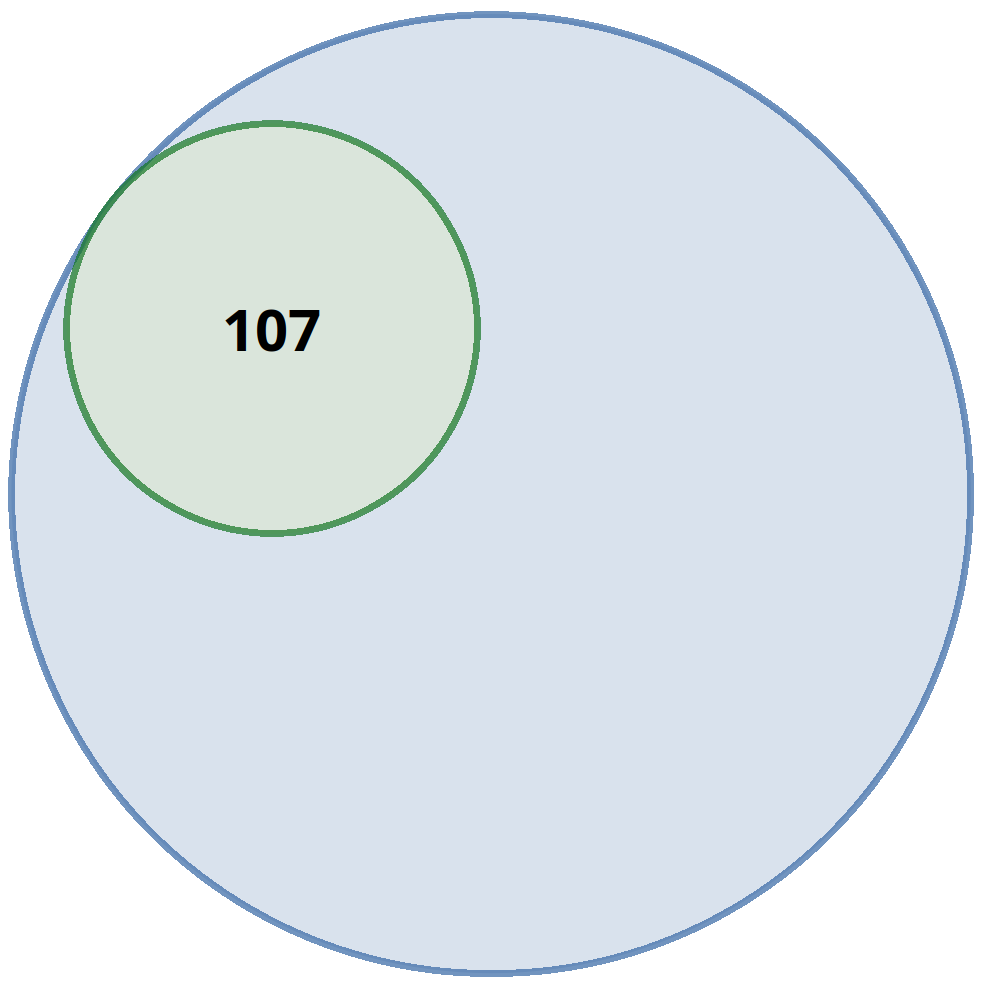
Requête 3 : Romans libertins 1782–1800
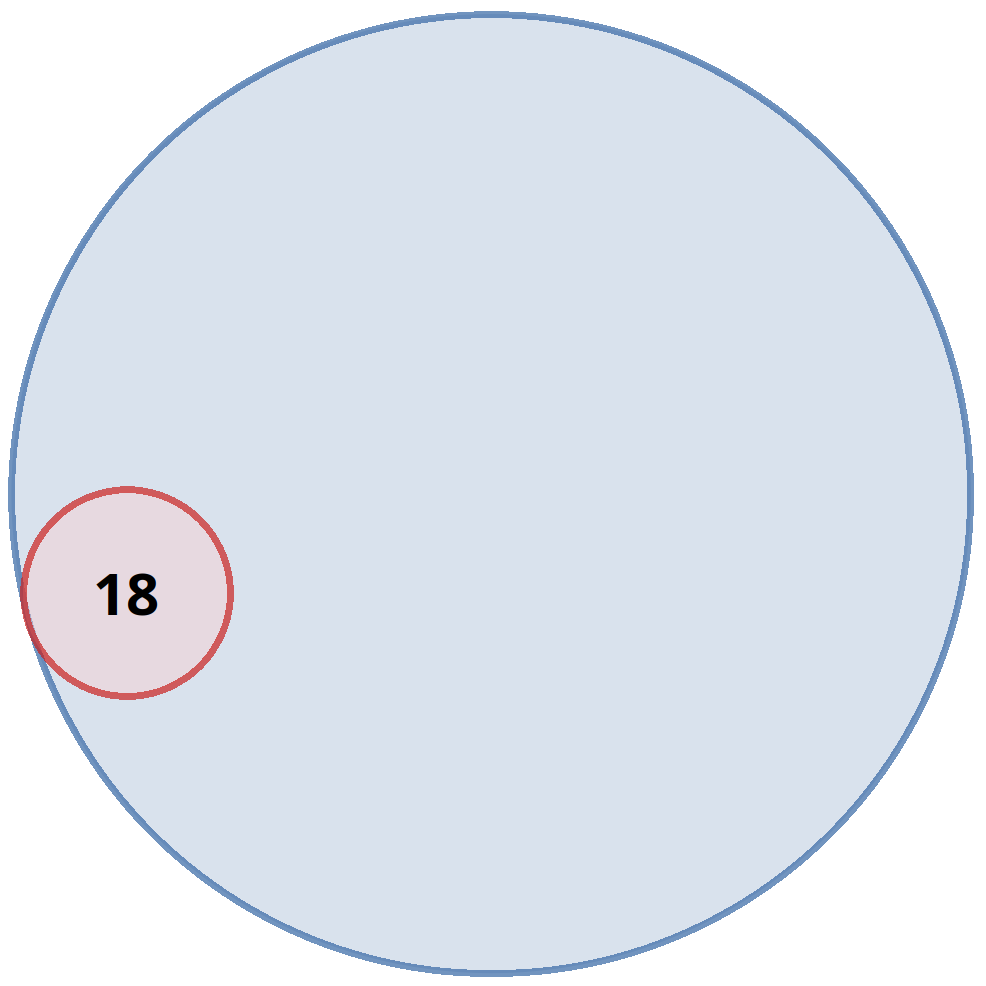
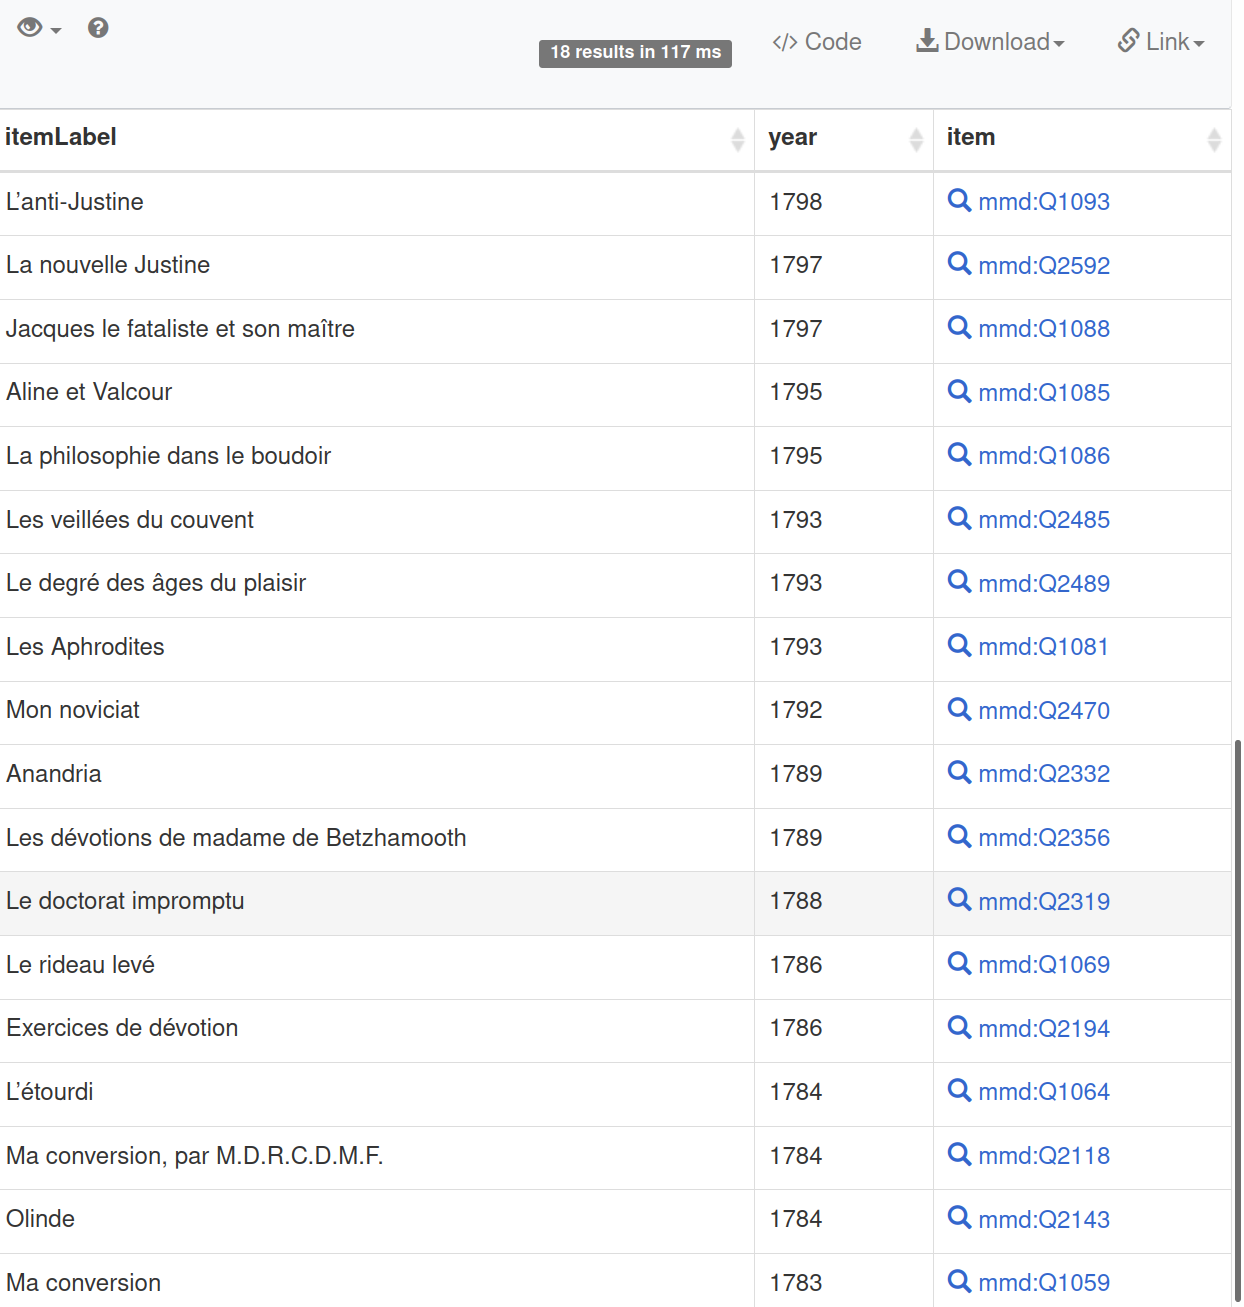
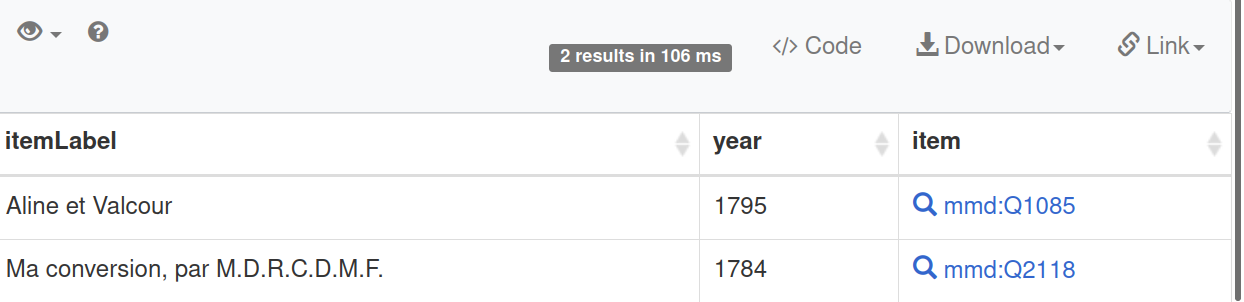
Requête 4 : Roman épistolaire liberin 1782–1800
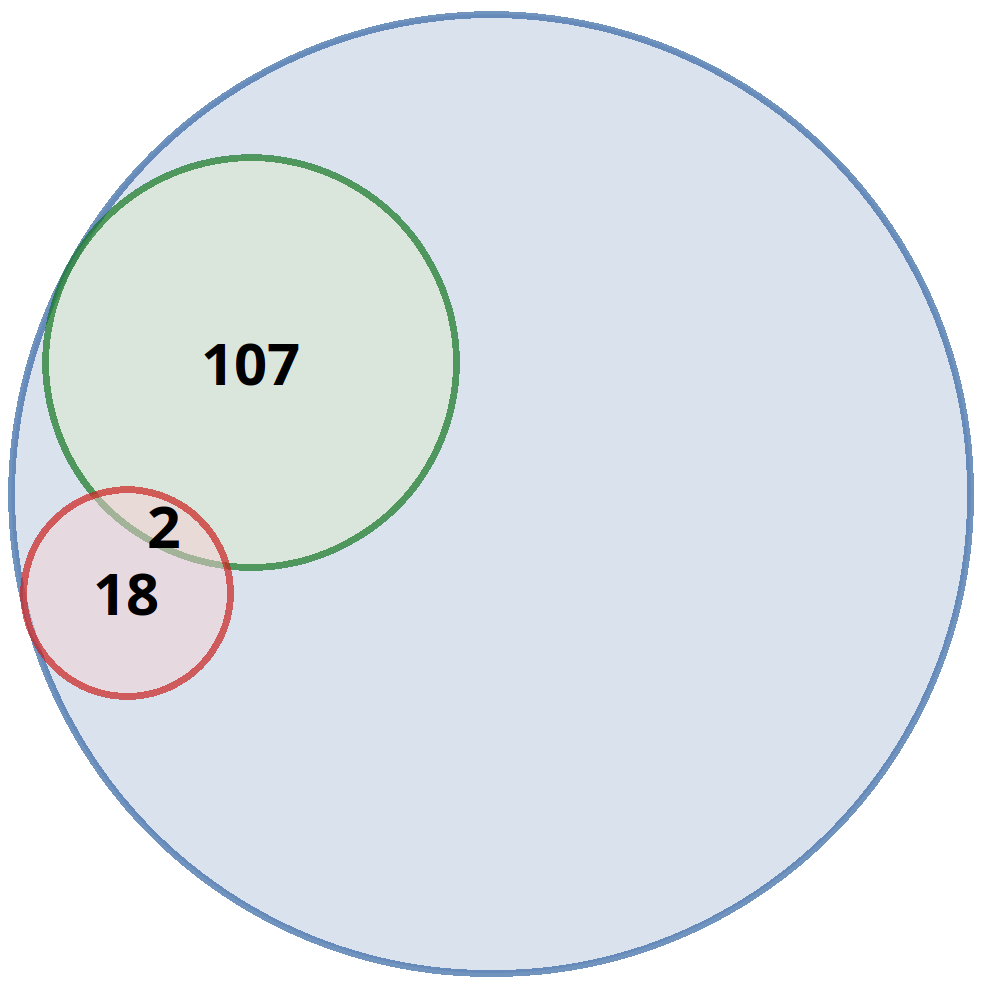
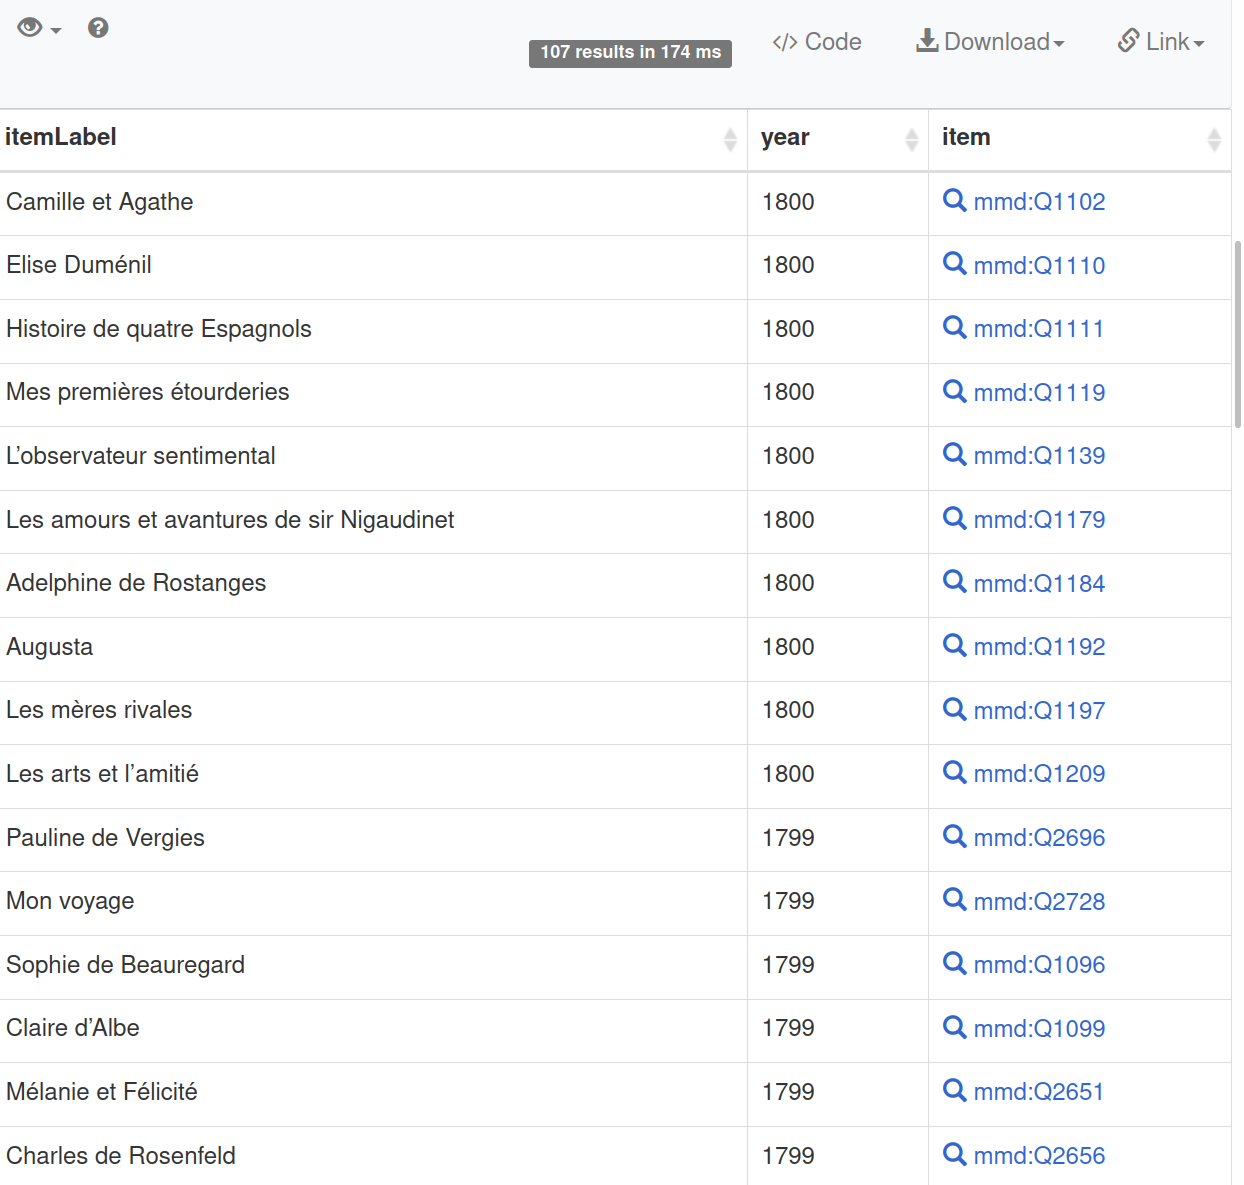
Requête 5 : Thème élargi : libertinage, erotisme et/ou passion
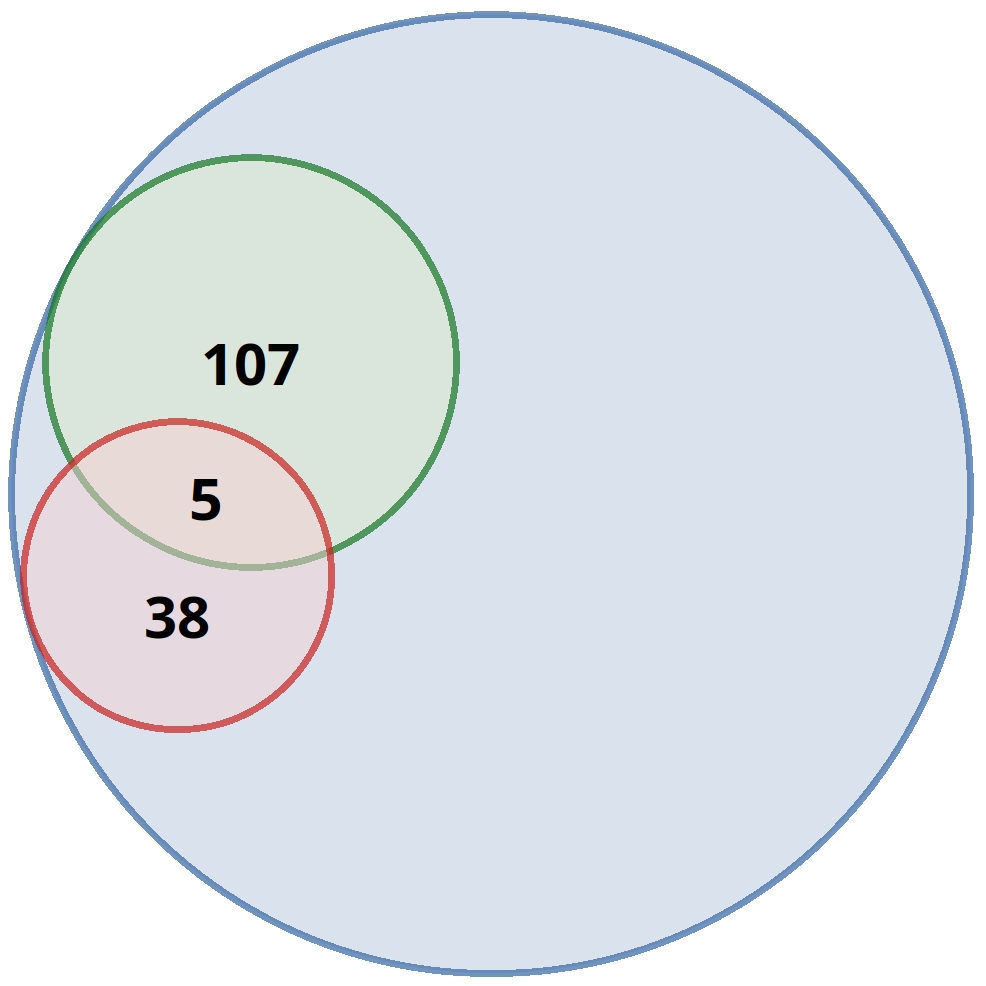
Requête 6 : Forme élardie : romans décrits avec le mot “lettre(s)”
Une réponse ?

  • Bien sûr, tout est question de définitions
  • Notre modélisage nous permet de ‘moduler’ les définitions dans les requêtes
    • Epistolarité : cateǵorie sémantique ou séquence de lettres
    • Libertinage: thématique explicite ou élargie
  • En fonction de la définition, entre 2 et 8 romans libertins épistolaires après 1782
  • En plus, deux romans pertinents décrits par Benoît Melançon qui manquaient dans MiMoText !

Conclusion

Ce que fait une base de données au savoir d’histoire littéraire

  • Non pas des faits, mais des ‘assertions’ (générées, sourcées, contextuelles)
  • Une ‘atomisation’ du savoir historique : 336.000 micro-assertions au lieu d’une synthèse en prose
  • Une transparence dans la production des savoirs
  • Une mise en réseau du savoir : notre base n’est qu’une parmi d’autres
  • Naviguer la réduction de la complexité à travers la modélisation sémantique, et le détail des sources
  • Une manière d’intégrer des données hétérogènes (modélisage sémantique et granularités variables)

Les interfaces et leur effets

  • Une interface multilingue : affichage des labels en français, allemand, anglais
  • Un challenge des interfaces : multiplicité, complexité, apprentissage nécessaire
  • Fédération : un aspect essentiel du LOD, mais pas facile à réaliser
  • Ouverture : prérequis pour toute fédération, nécessité première

Un grand merci

Pour en savoir plus

References


Hinzmann, Maria, Matthias Bremm, Tinghui Duan, Julia Konstanciak, Julia Röttgermann, Moritz Steffes, Christof Schöch, and Joëlle Weis. 2024. “Patterns in modeling and querying a knowledge graph for literary history [preprint].” In Pattern Theory in Language and Communication, edited by Sabine Arndt-Lappe, Milena Belosevic, Peter Maurer, Claudine Moulin, Achim Rettinger, and Sören Stumpf. Trier: TCLC. https://doi.org/10.5281/zenodo.12080340.
Martin, Angus, Vivienne G. Mylne, and Richard Frautschi. 1977. Bibliographie du genre romanesque français, 1751-1800. Mandell.
Röttgermann, Julia. 2024. “The Collection of Eighteenth-Century French Novels 1751-1800.” Journal of Open Humanities Data 10 (1): 31. https://doi.org/10.5334/johd.201.
Schöch, Christof, Maria Hinzmann, Julia Röttgermann, Katharina Dietz, and Anne Klee. 2022. “Smart Modelling for Literary History.” International Journal of Humanities and Arts Computing 16 (1): 78–93. https://doi.org/10.3366/ijhac.2022.0278.

Appendix 1 : Bonus slides

Literary History 101

  • Goals of literary history
    • Collect and document knowledge about literature over time
    • Contextualize literature, document reception of literature
    • Provide explanations for the ‘evolution’ of literature
  • Organizational principles
    • Nations, periods, movements/currents, genres, authors
    • Authors and works: themes, forms, characters, setting, plot, etc.
    • Similarities and differences, continuities and change

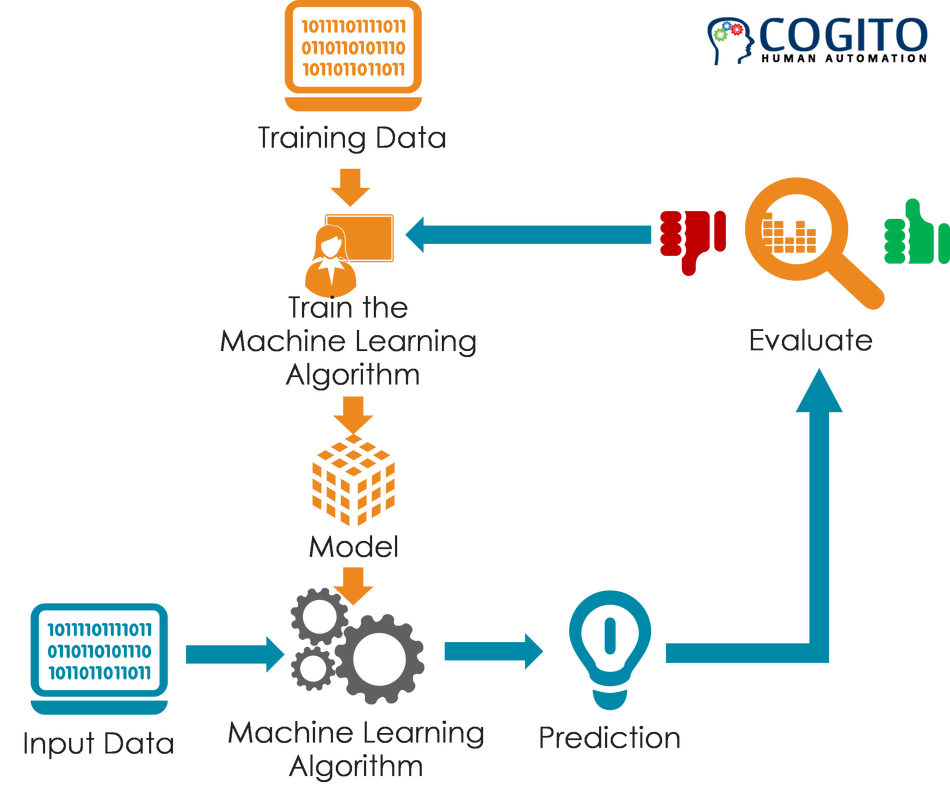
Machine Learning for Literary History

  • Fundamentally, ML involves detecting relations between simple and complex properties of texts
    • Simple properties (features): we can observe in texts (e.g.: word forms)
    • Complex phenomena (classes): relevant to our research (e.g.: direct speech or themes)
  • We use this approach primarily for literary information retrieval
    • We may annotate part of our texts and train a new model
    • Or we may use an existing model (or unsupervised approaches)
    • Evaluate the performance of the model on the annotated data
    • And then identify complex phenomena in unannotated text
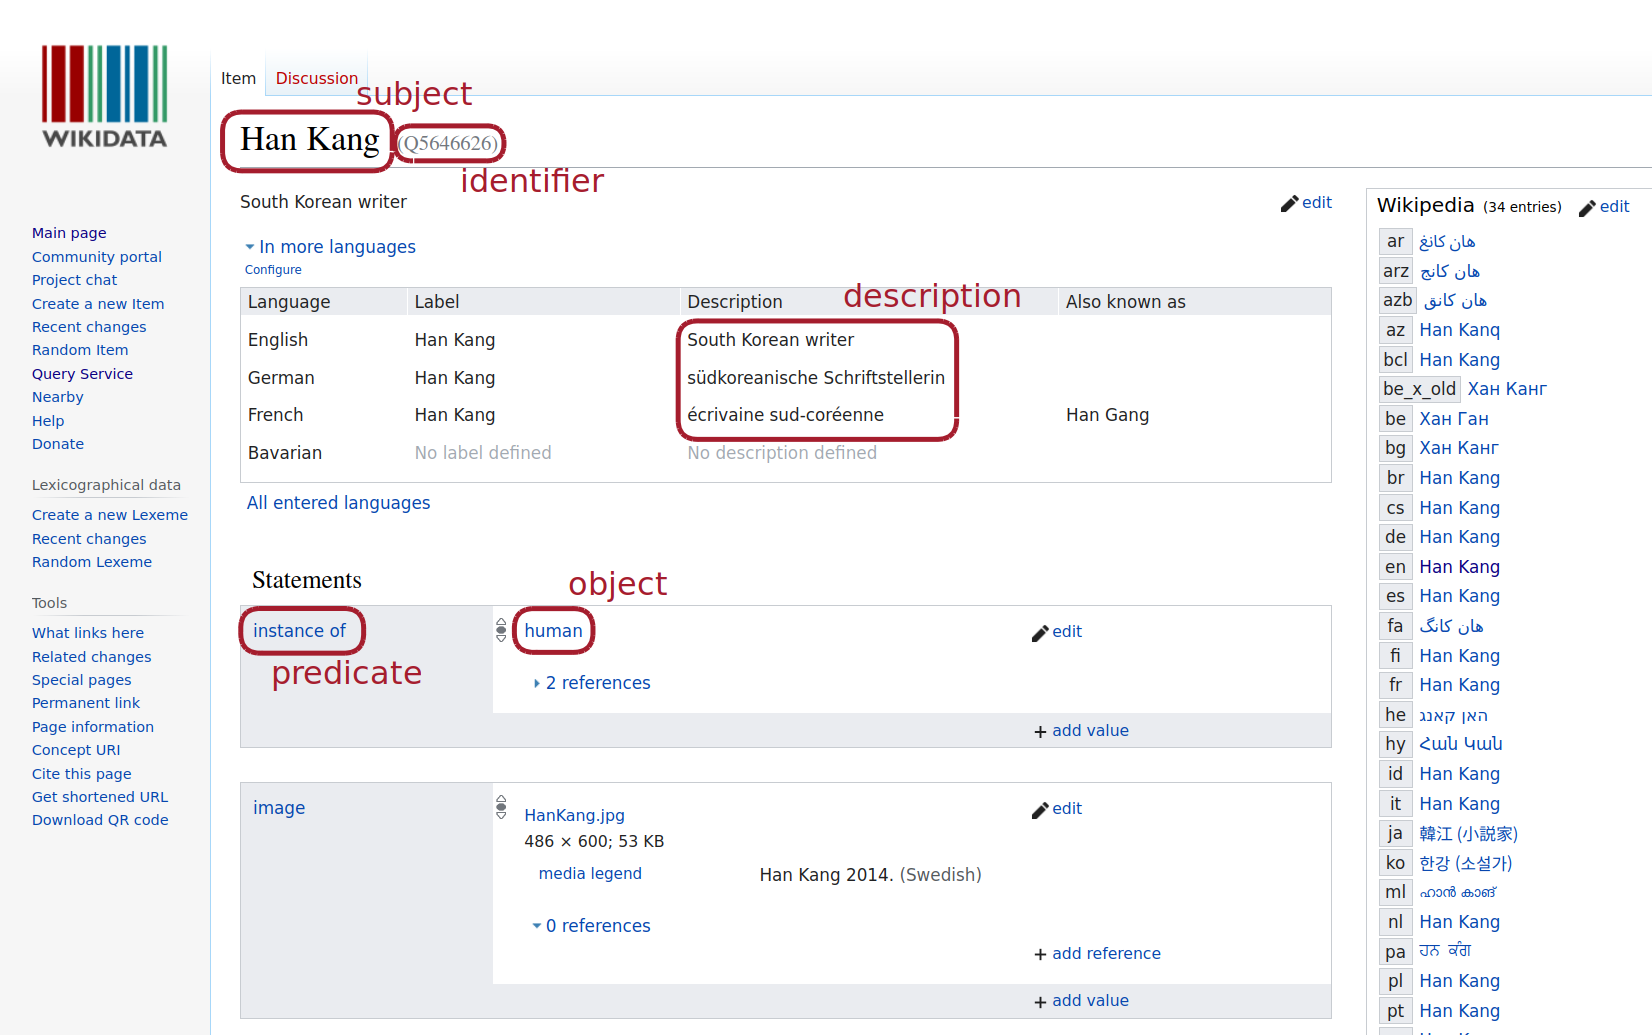
Linked Open Data for Literary History
Modélisation sémantique : exemple des thèmes
Appendix 2 : Sample queries

Some sample queries: simple queries

Example queries: visualizations

Sample queries: networked and federated

Sample queries: comparative queries